Gestire cluster Talos, dalla macchina vuota all’aggiornamento. Gira accanto al cluster, non al suo interno.
Accanto al cluster
Resta raggiungibile anche quando il cluster è fermo.
Diretto su Talos
Parla con l’API delle macchine. Nessun agente, nessun talosctl.
Dal metallo al nodo
Trovare, verificare, configurare e inserire le macchine.
Aggiornamenti sicuri
Nodo per nodo, con un piano, uno snapshot etcd fresco e un controllo di salute.
Alpha 0.8.0: holzkube-manager è agli inizi e cambia molto. Funzioni, impostazioni e formati dei dati possono cambiare a ogni versione. Prima di aggiornare fate un backup e leggete le note di rilascio.
holzkube-manager gestisce cluster Kubernetes su Talos Linux. Un solo binario Go gira fuori dal cluster e parla direttamente con l’API delle macchine Talos. Non servono né un agente nel cluster né un servizio cloud. È pensato come alternativa self-hosted a Sidero Omni, con AGPL-3.0 invece di BUSL-1.1.
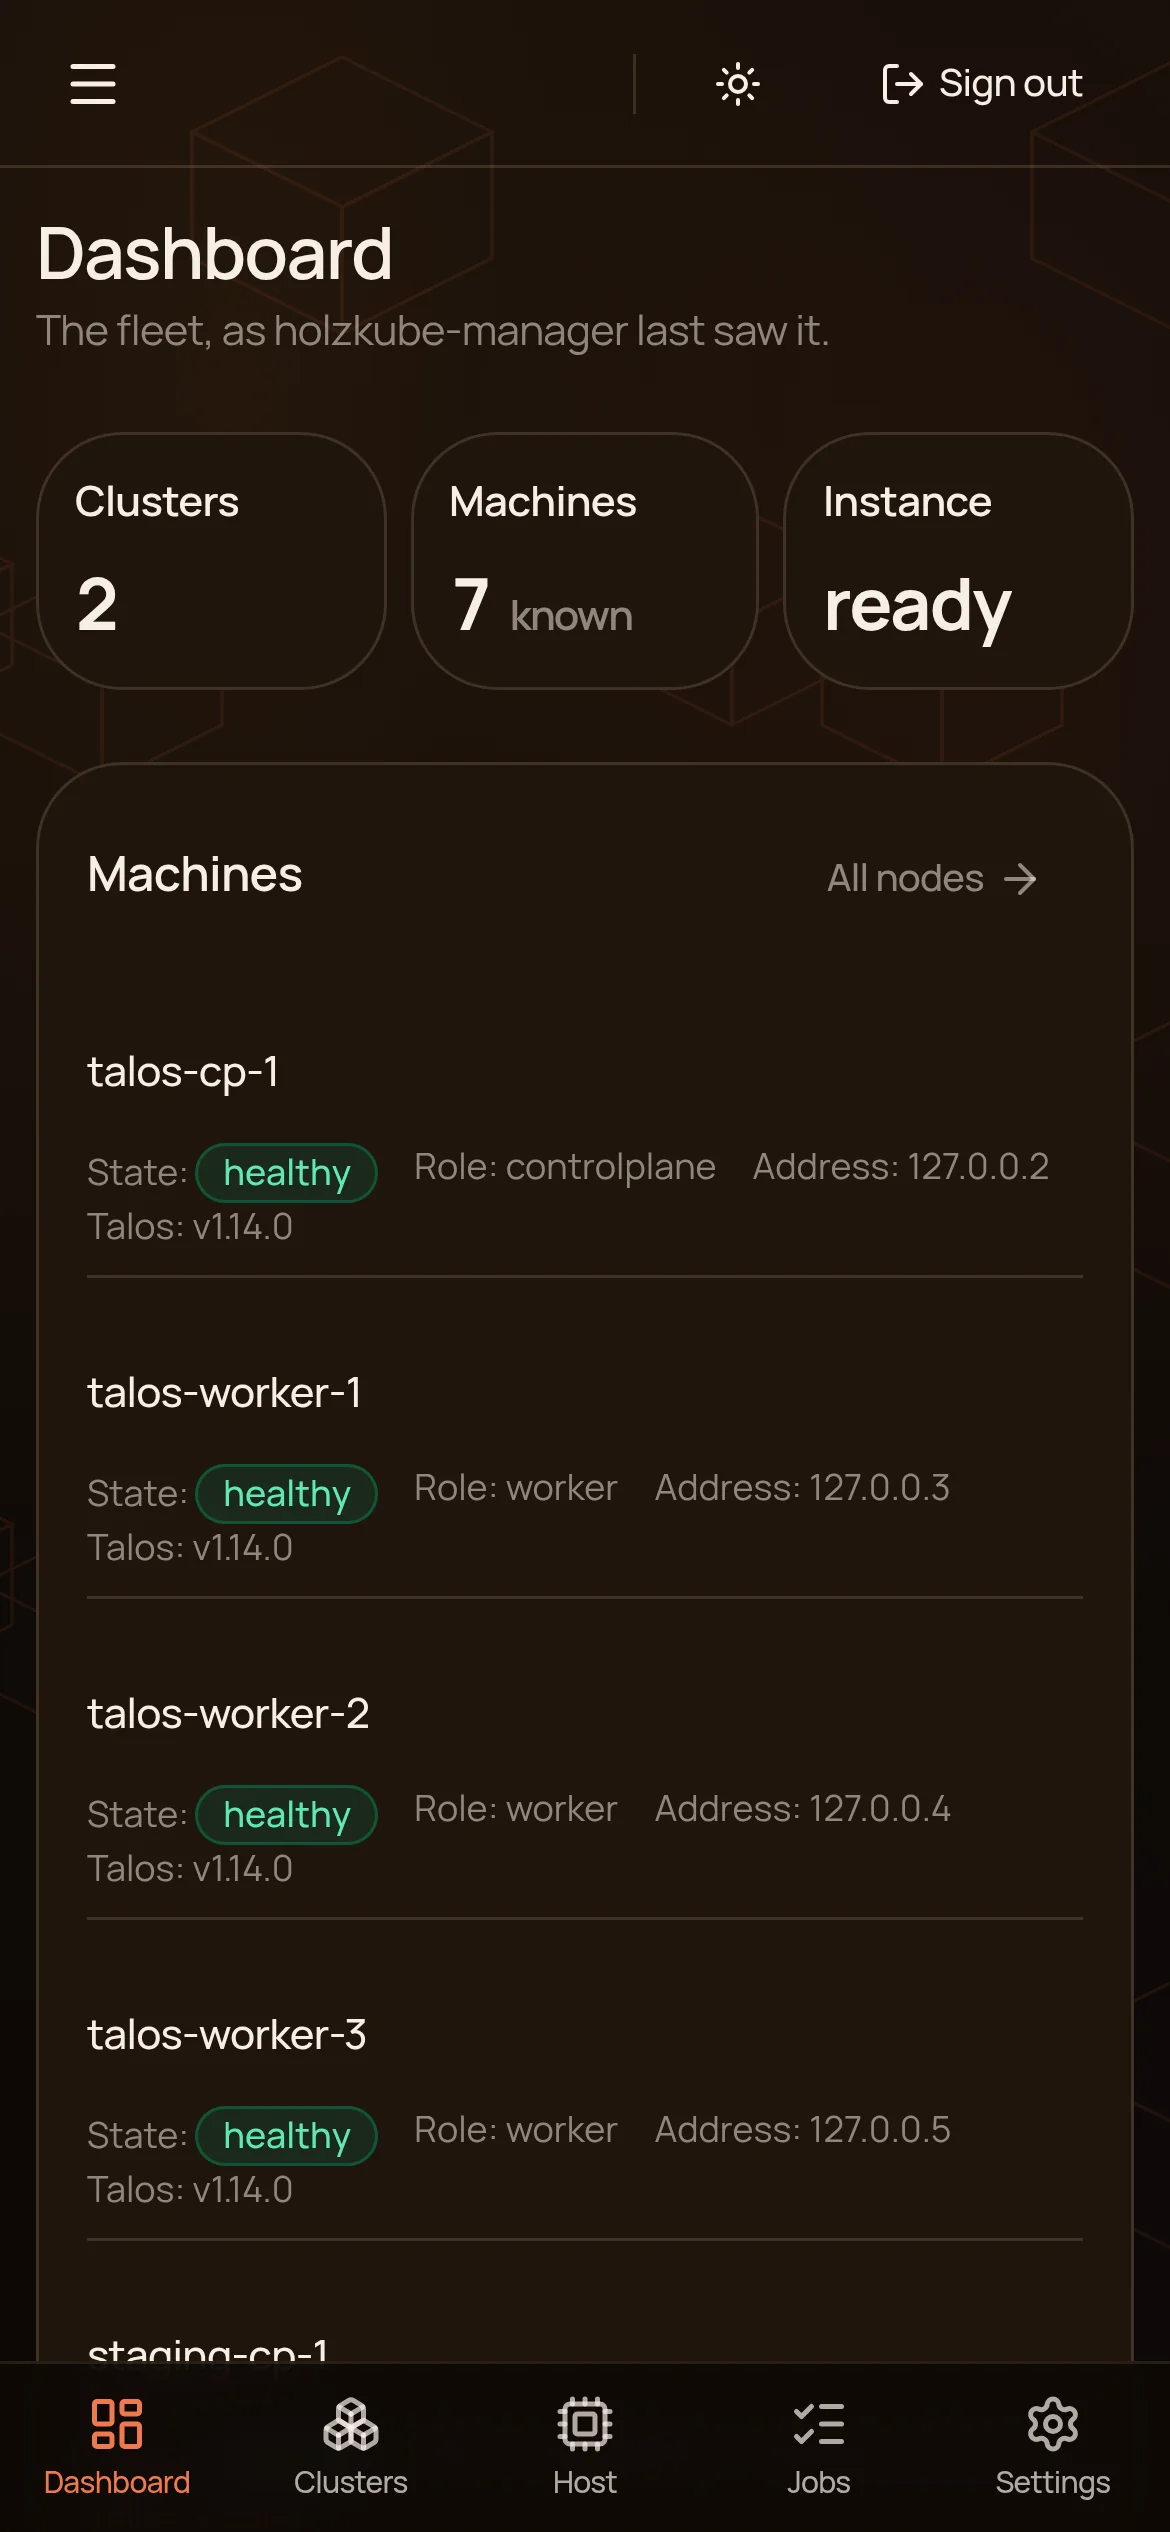
Chi deve rimettere in piedi un cluster non può contare su uno strumento che gira al suo interno. Perciò un binario, una cartella di dati, HTTPS dal primo avvio, per esempio su un Raspberry Pi 5 accanto al cluster. L’interfaccia funziona dallo schermo a parete fino al telefono.
Versione 0.8.0 — release su GitHub. Funziona con un vero cluster Talos; le build esistono solo per linux/arm64 (Raspberry Pi 5). Il controllo dei certificati nel cluster è stato provato finora solo su un simulatore; sensori dal vivo, Wake-on-LAN e azioni Talos forzate non sono ancora stati provati su hardware reale. La deriva della configurazione non è mai stata eseguita su un vero cluster Talos: che Talos non riscriva da solo la configurazione, che un nodo restituisca dopo un apply ciò che è stato inviato, i tempi dopo un riavvio e il banner dopo ore reali non sono verificati. Un valore di secret modificato da solo resta invisibile.
Funzioni
Dalla macchina vuota al nodo
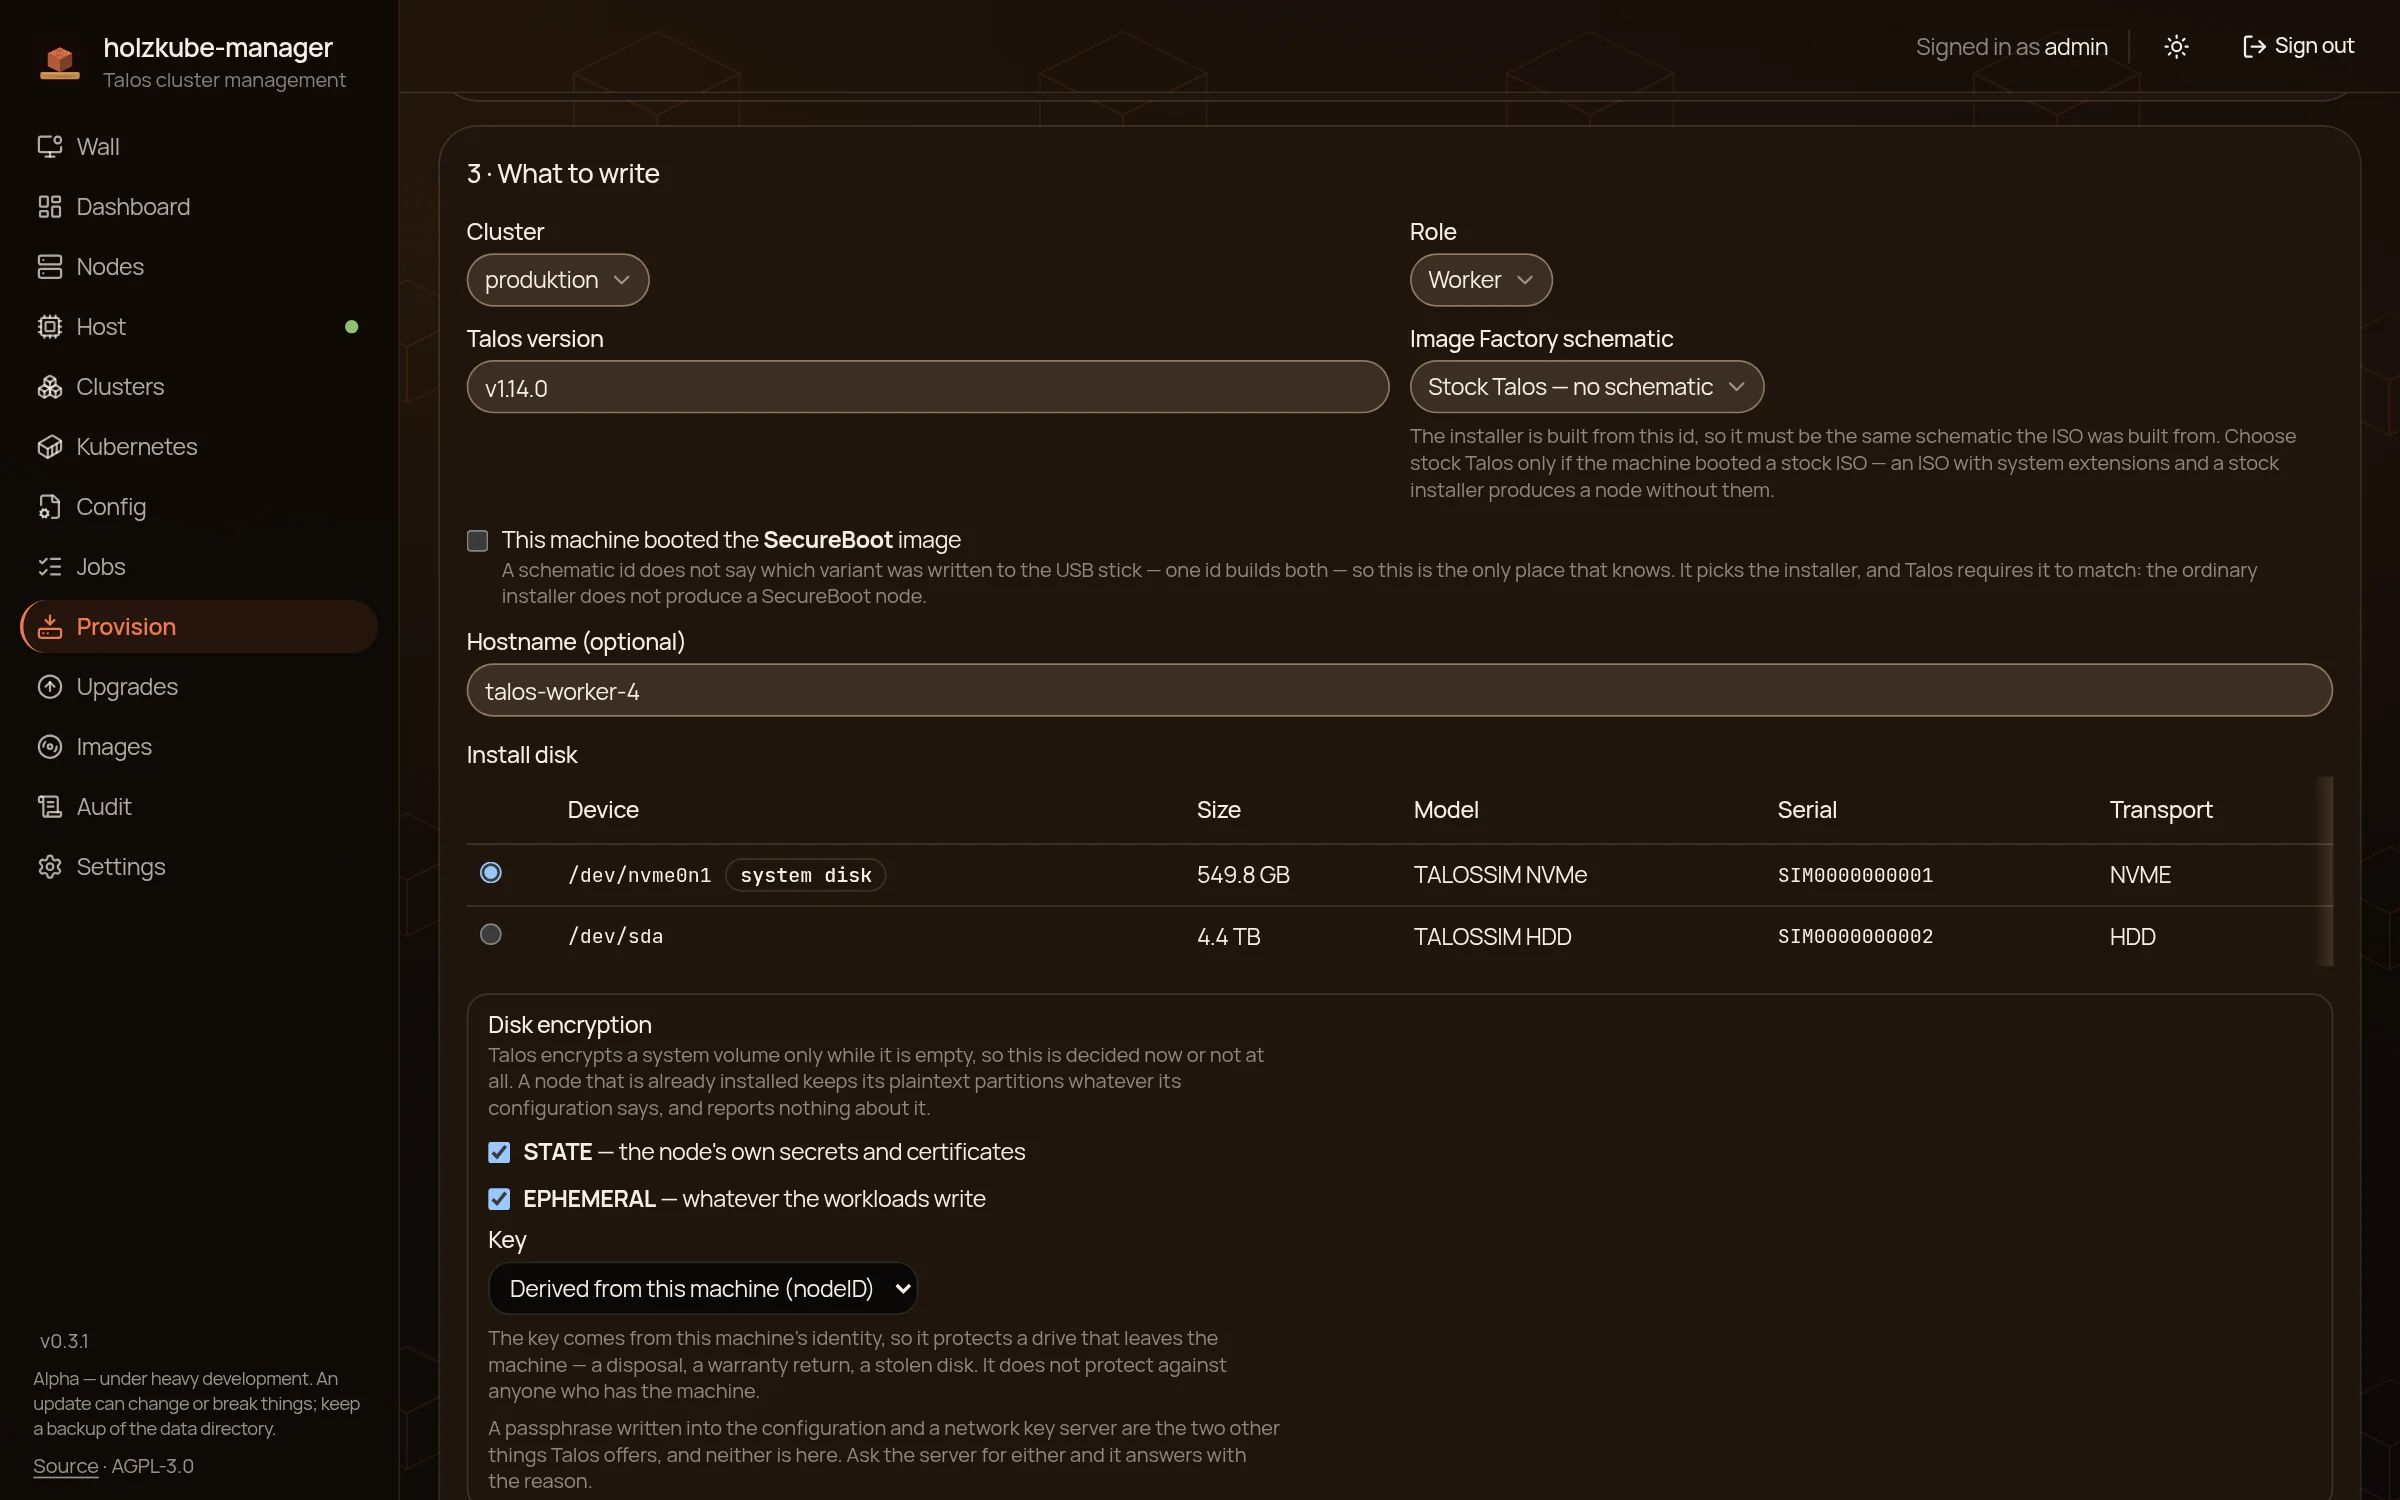
Un assistente trova le macchine avviate dall’ISO di Talos, controlla l’impronta del certificato e scrive la configurazione. Disco di installazione, nome host e cifratura TPM si scelgono prima.
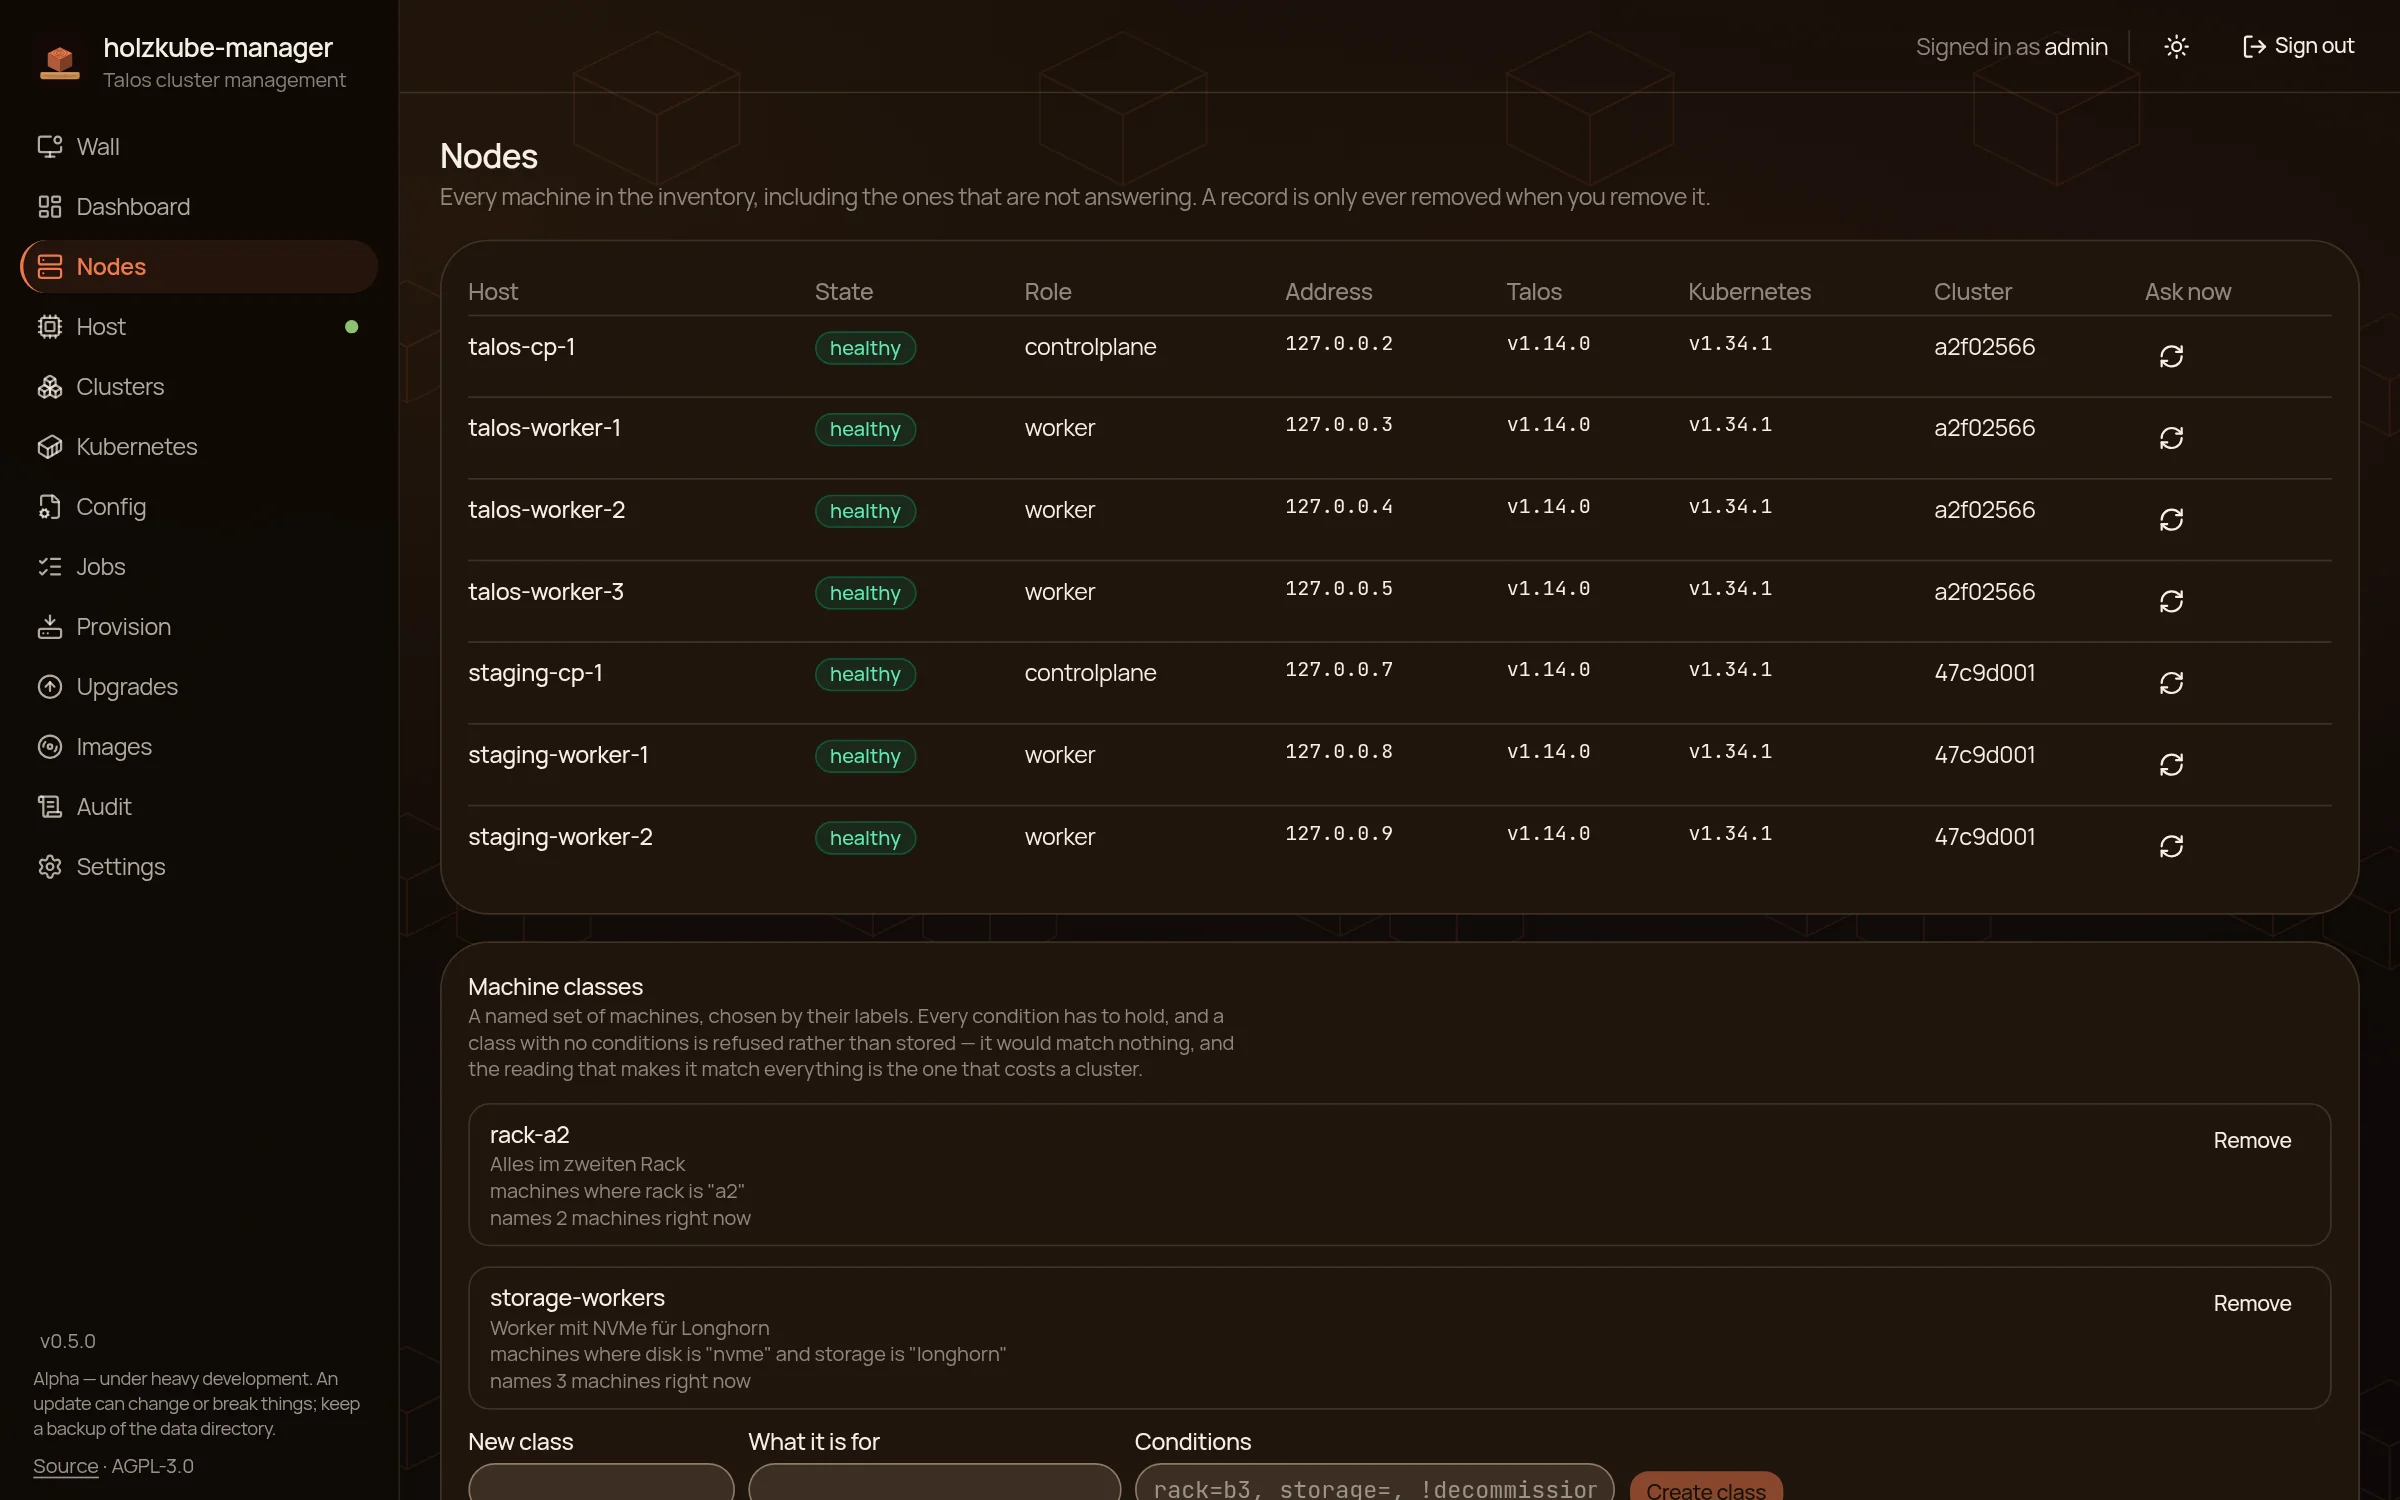
Inventario e nodi
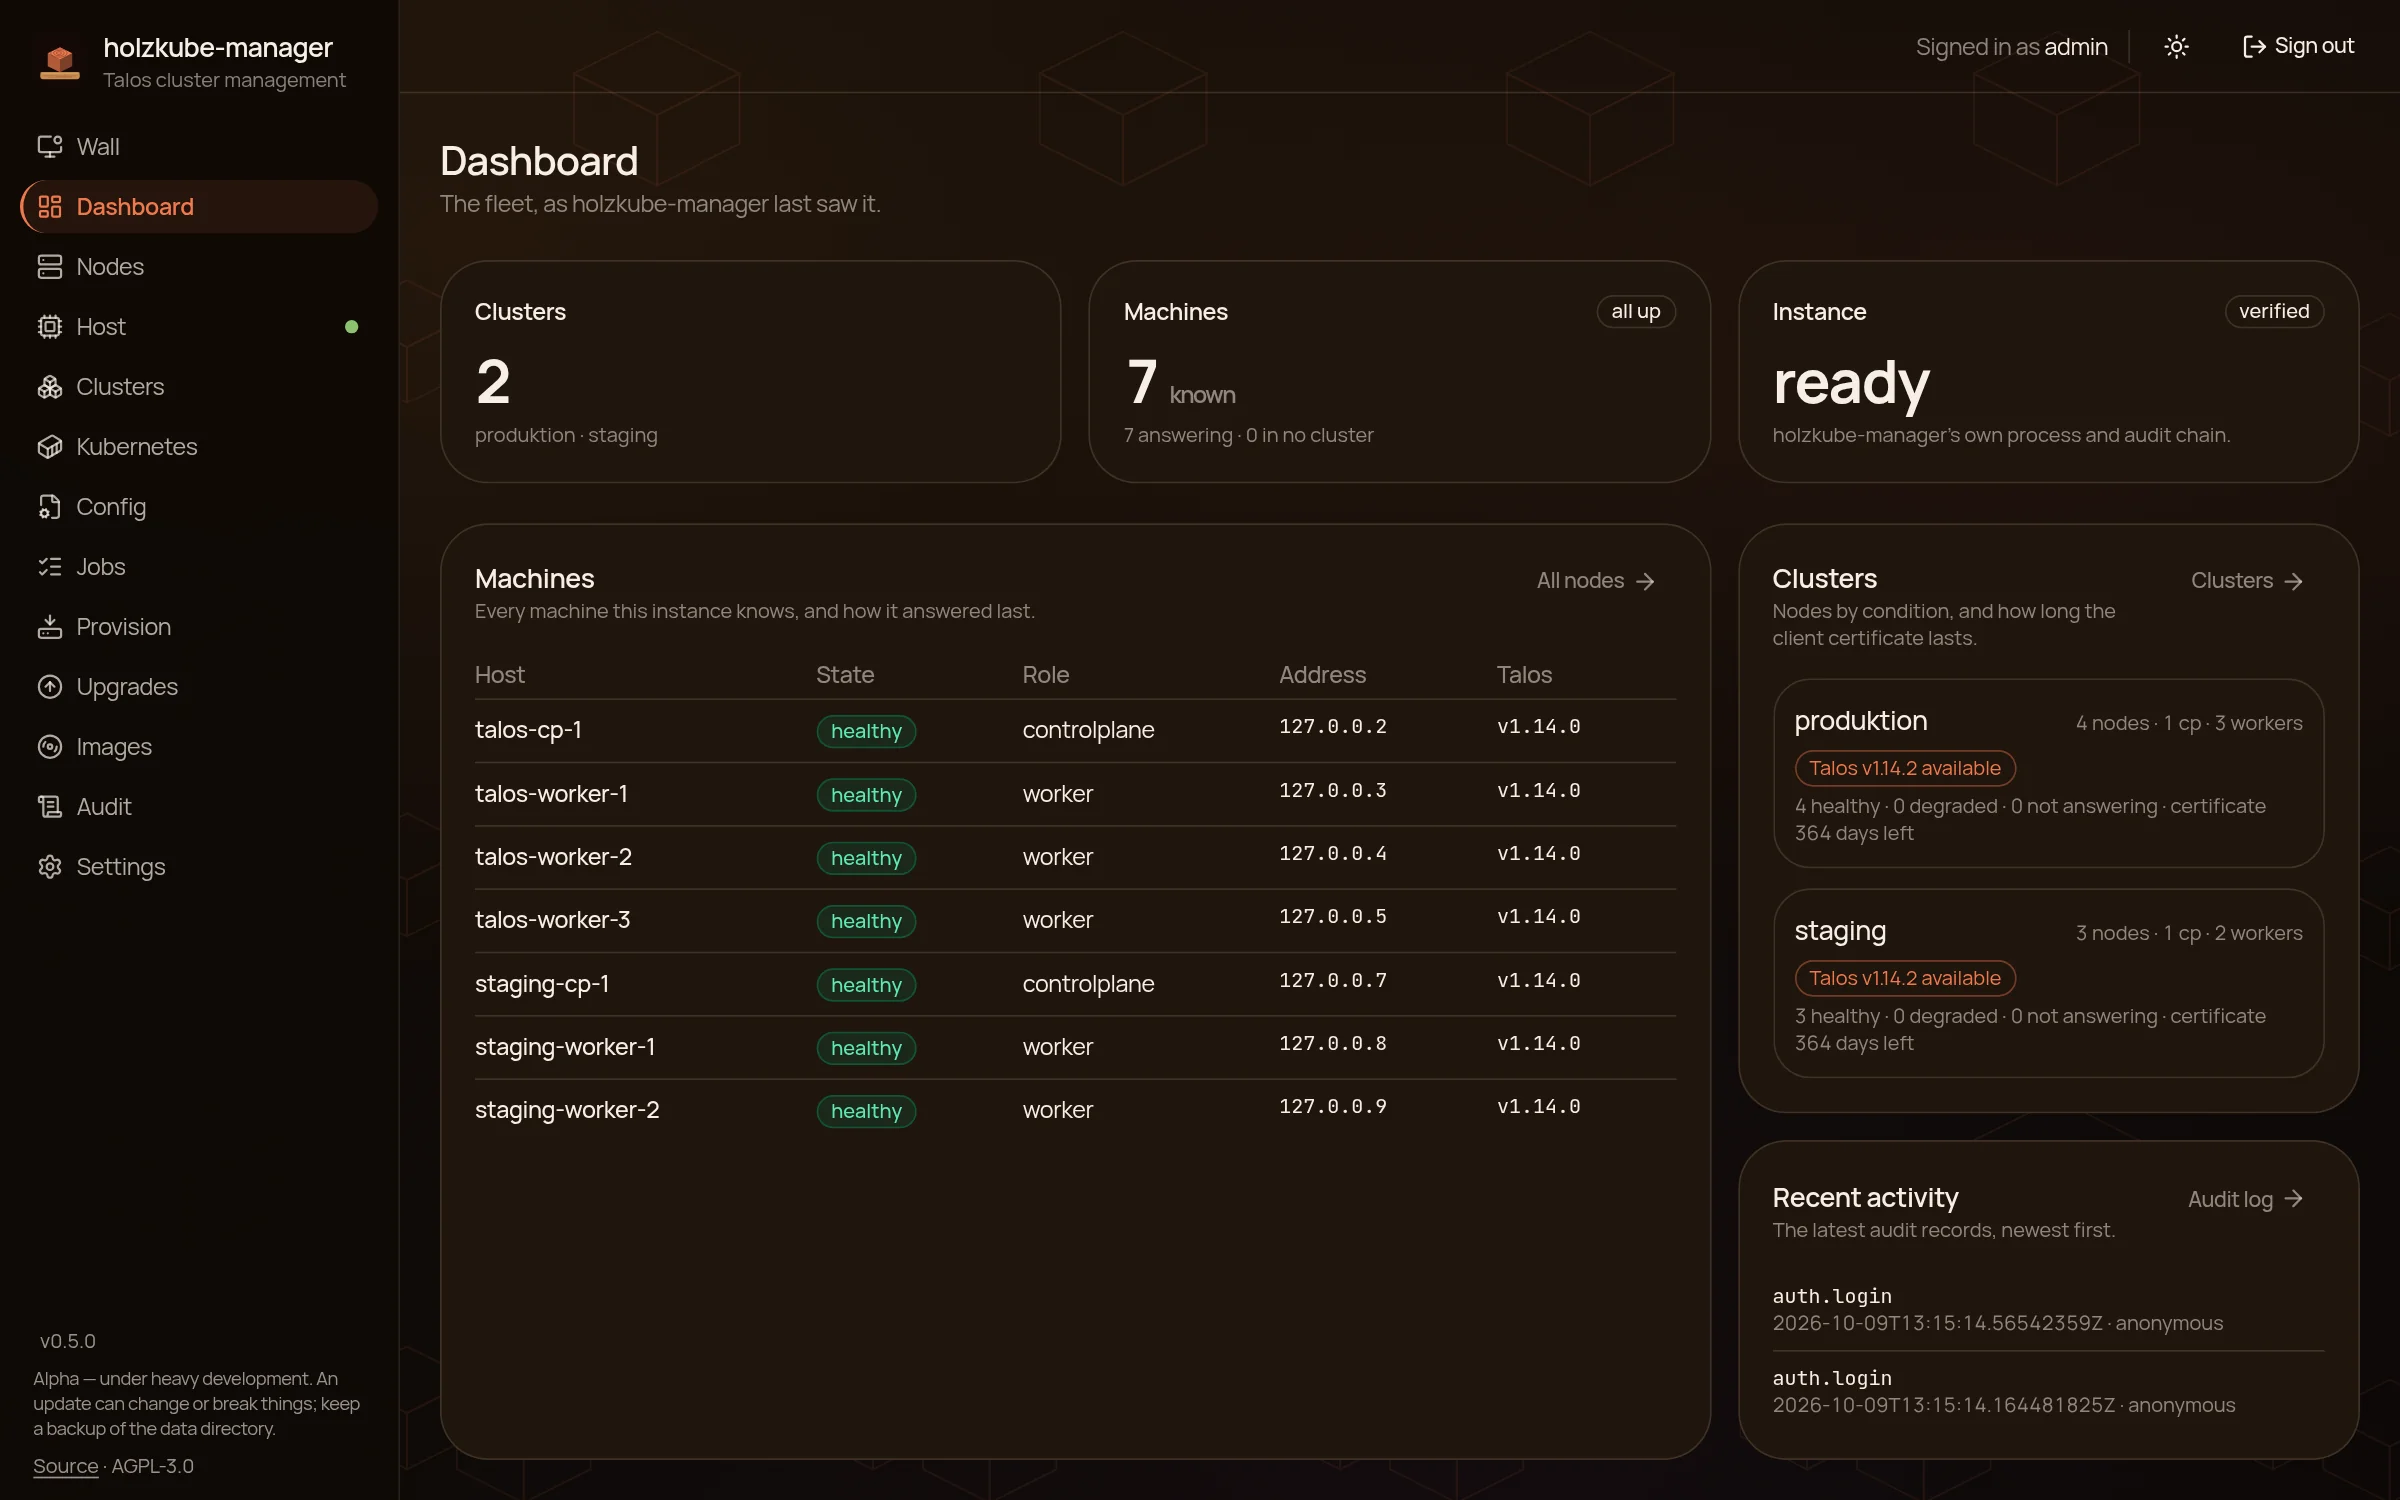
Ogni macchina con stato, ruolo, indirizzo e versioni, anche se al momento non risponde. Riavvio, reset o rimozione chiedono di nuovo conferma. Un nodo si rimuove con un job: fuori da etcd, disco di sistema cancellato, dimenticato. Il job riprende dopo un riavvio.
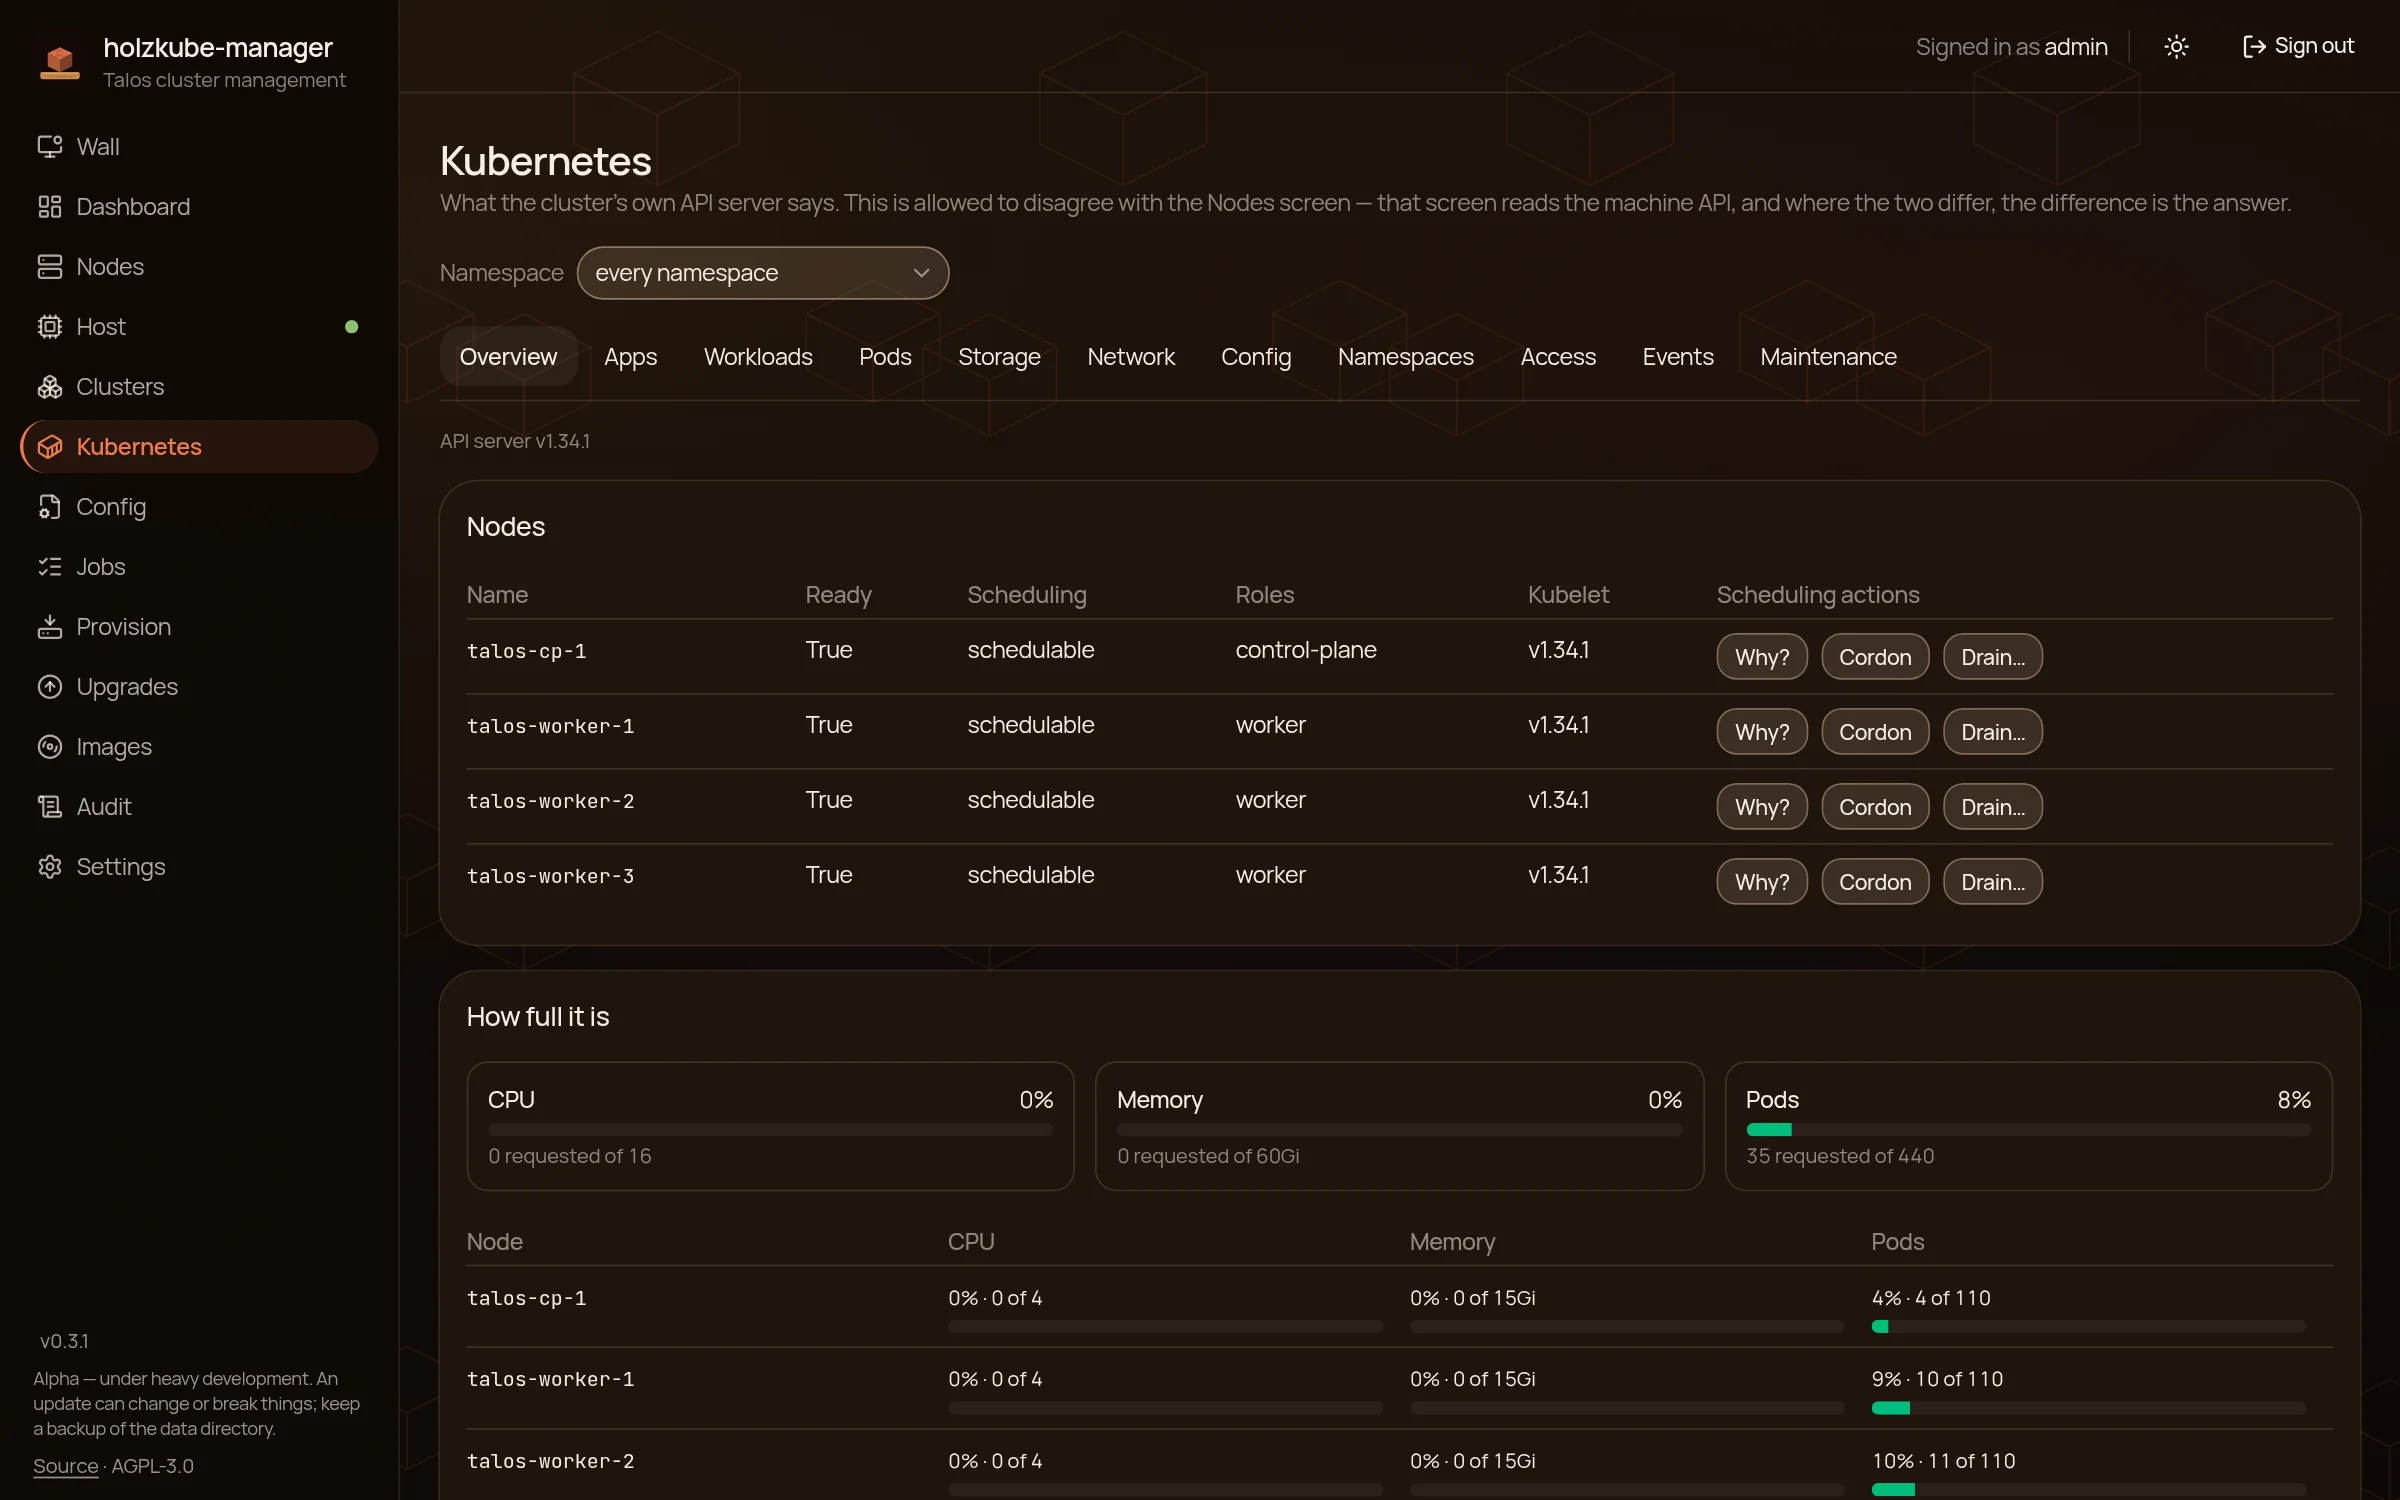
Kubernetes a colpo d’occhio
Dieci viste, dai workload agli eventi. Cordon e drain dei nodi, scalare o rilanciare i deployment, e per un pod guasto il log dell’esecuzione andata in crash lì accanto.
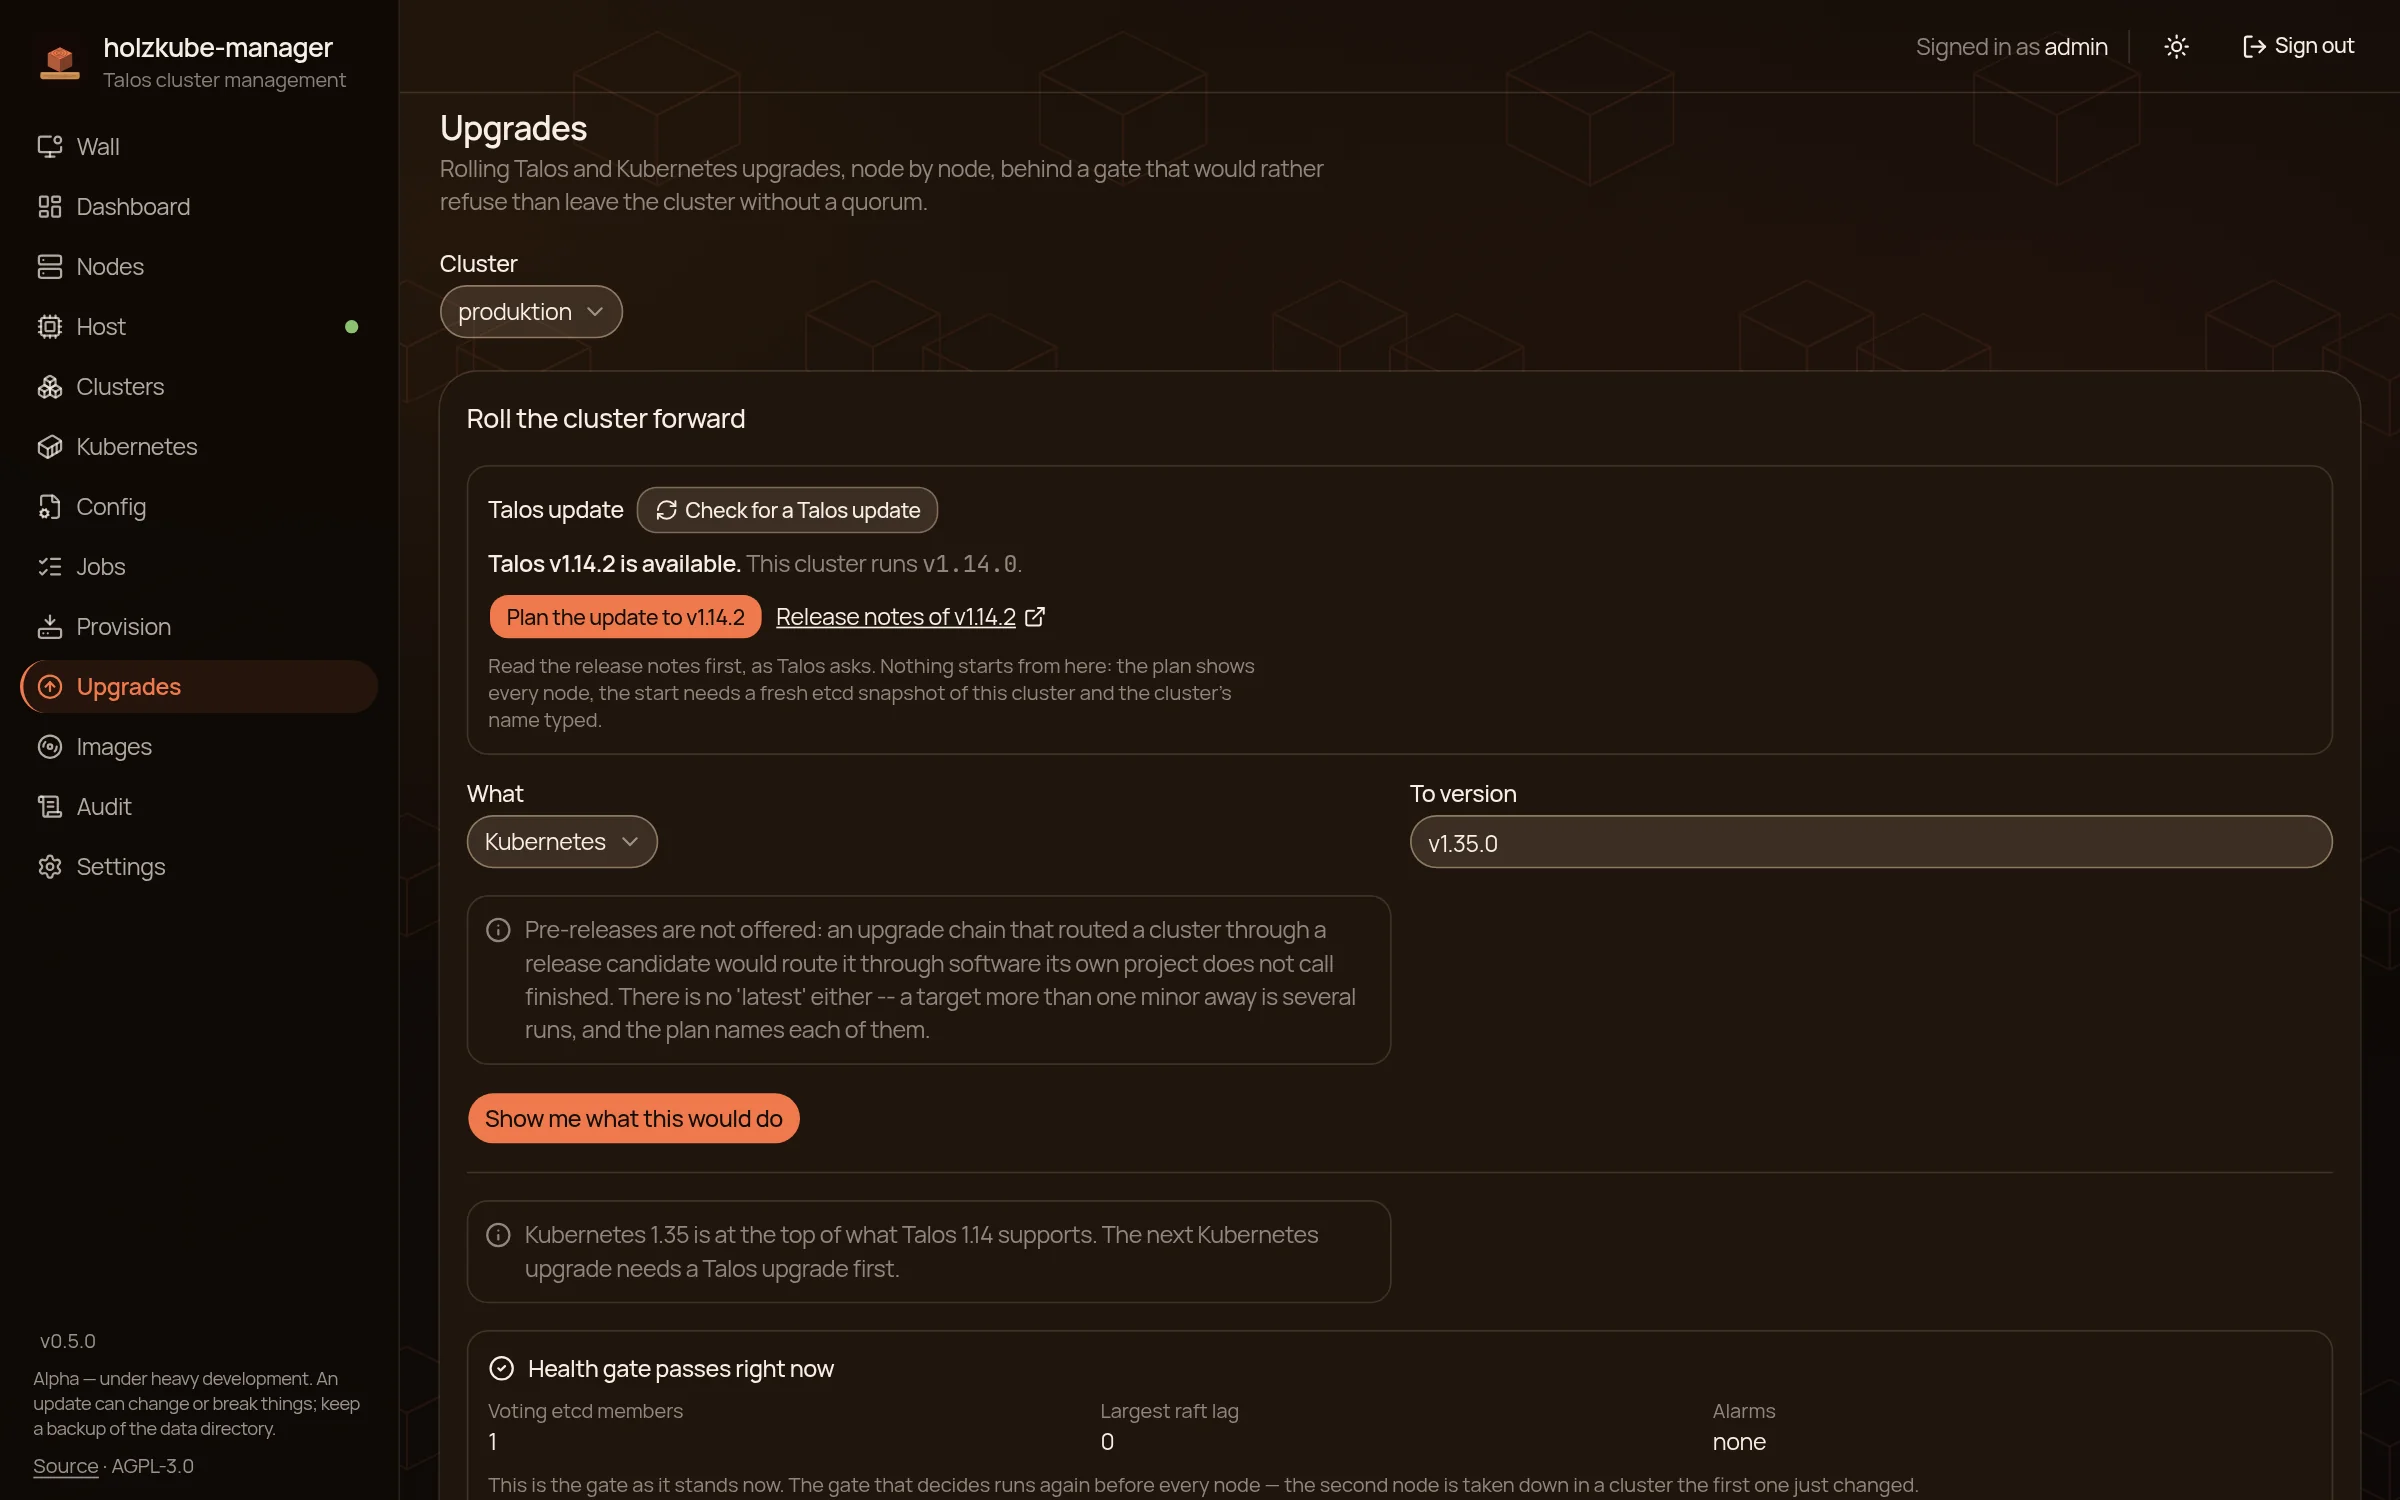
Aggiornamenti con la cintura
Talos e Kubernetes si aggiornano nodo per nodo. Prima un piano mostra ogni passo. Un aggiornamento di Talos parte solo con uno snapshot etcd fresco e prima di ogni nodo un controllo di salute verifica il quorum di etcd. Se la meta dista più versioni minori, il piano indica l’ultima patch di ogni versione intermedia.
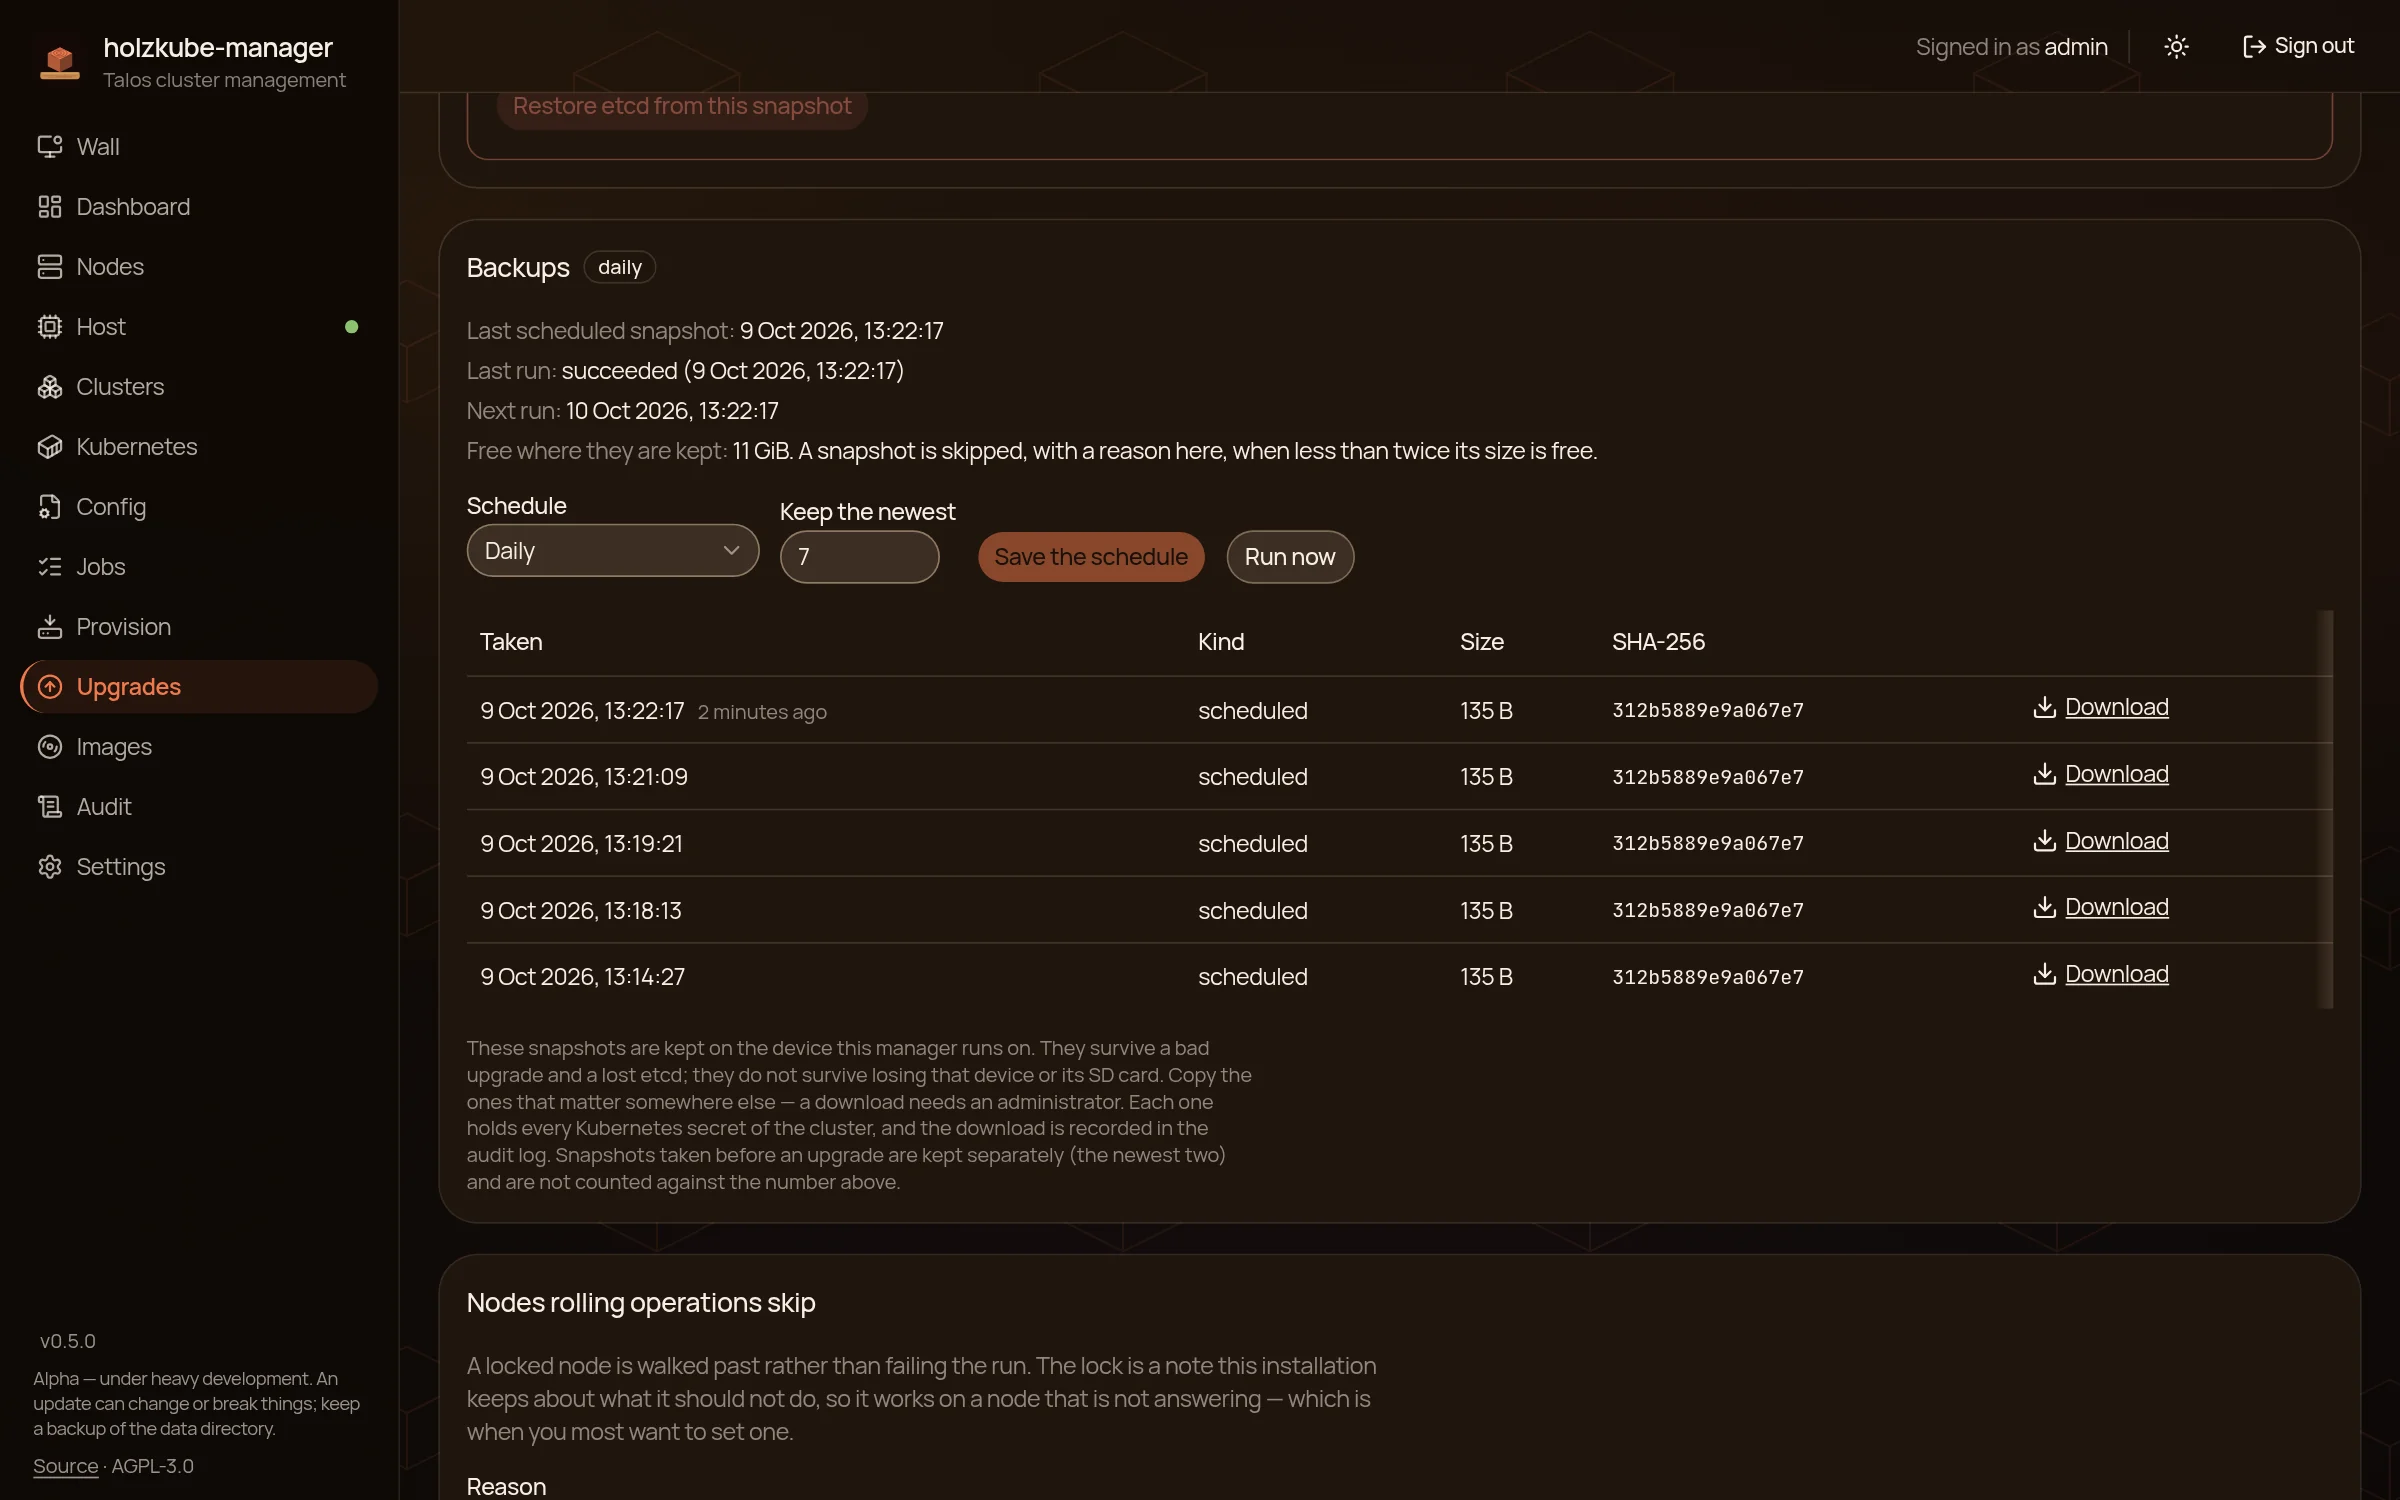
Backup etcd pianificati
Ogni 6 ore, ogni giorno o ogni settimana, con il numero di snapshot da conservare. L’elenco mostra dimensione e SHA-256. Se l’ultimo backup ha più di due intervalli, il cluster risulta in ritardo. I backup restano sul dispositivo e non sopravvivono alla perdita della sua scheda SD: copiate altrove quelli importanti.
Certificati
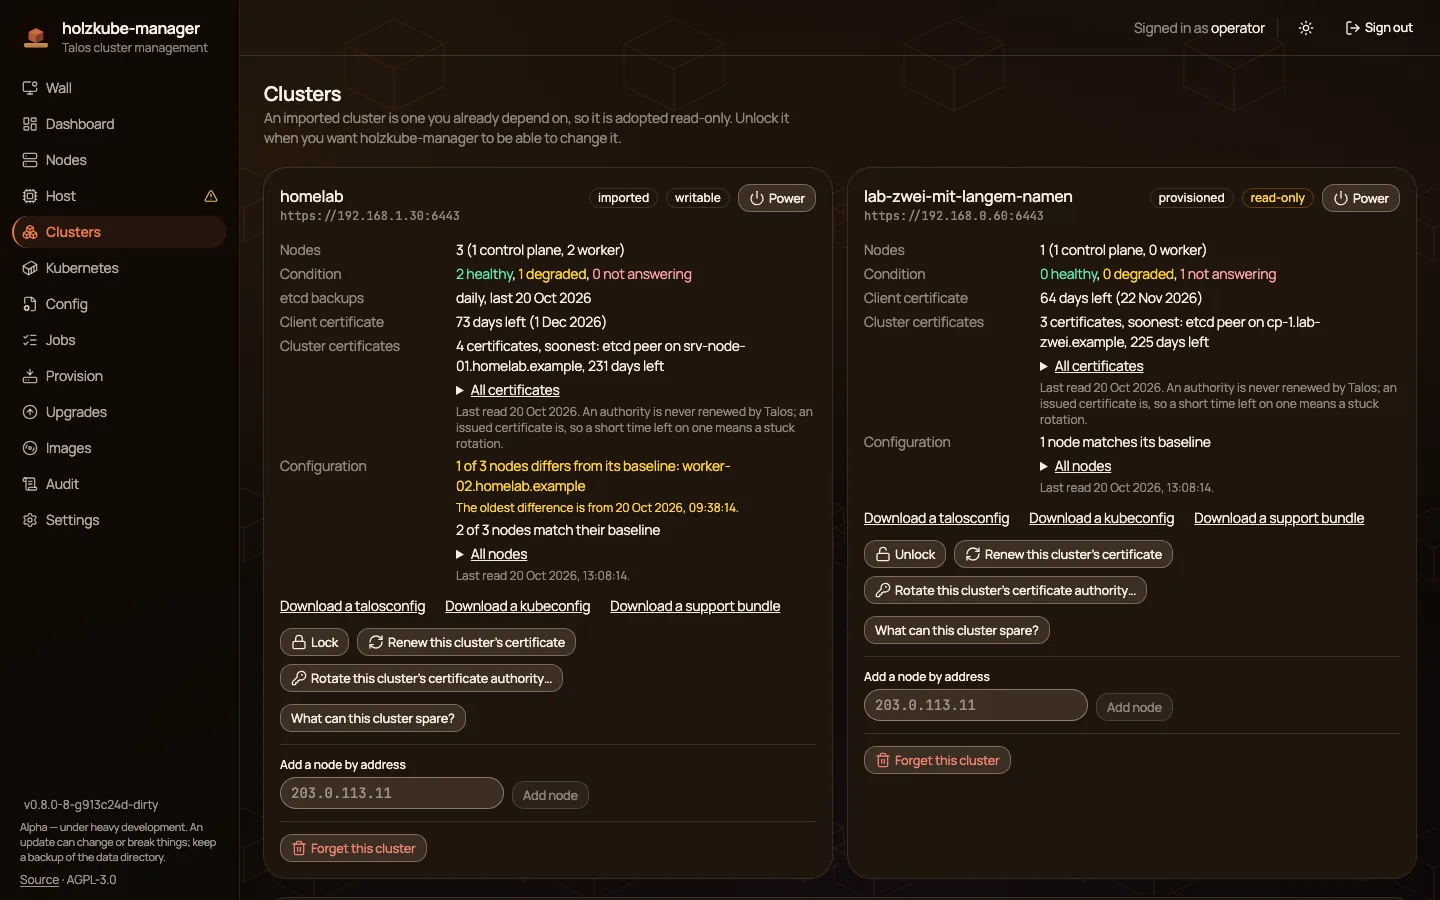
La scheda del cluster mostra la validità residua del certificato client e, sotto «Cluster certificates», quella dei certificati nel cluster (API Talos, etcd, Kubernetes e le loro CA), letti da ogni nodo control plane e ordinati dalla scadenza più vicina. Quando uno sta per scadere compaiono un banner su ogni pagina, una riga sul display a parete e un valore in /metrics. Il certificato client si rinnova, la CA di Talos si ruota con un job riprendibile. talosconfig, kubeconfig e support bundle si scaricano, ogni download finisce nel log di audit.
Deriva della configurazione
La configurazione attiva di ogni nodo viene letta ogni 3 ore e confrontata con ciò che holzkube-manager sapeva per ultimo o aveva scritto lui stesso. La baseline è una copia con i secret oscurati. Una modifica fatta sul nodo (talosctl, un altro operatore) compare con il suo diff nella pagina del nodo, come riga «Configuration» sulla scheda del cluster e in /metrics, e come banner quando resta 24 ore senza conferma. «Confirm as intended» rende lo stato attuale la nuova baseline, richiede il ruolo admin e la richiesta della password, finisce nel log di audit e non cambia nulla sul nodo. Le modifiche che holzkube-manager fa da solo (patch, aggiornamento di Kubernetes, rotazione della CA) non contano come deriva. La cartella dei dati passa per questo allo schema 7; una versione più vecchia ripristinata lo rifiuta, la guida spiega come tornare indietro.
Display a parete
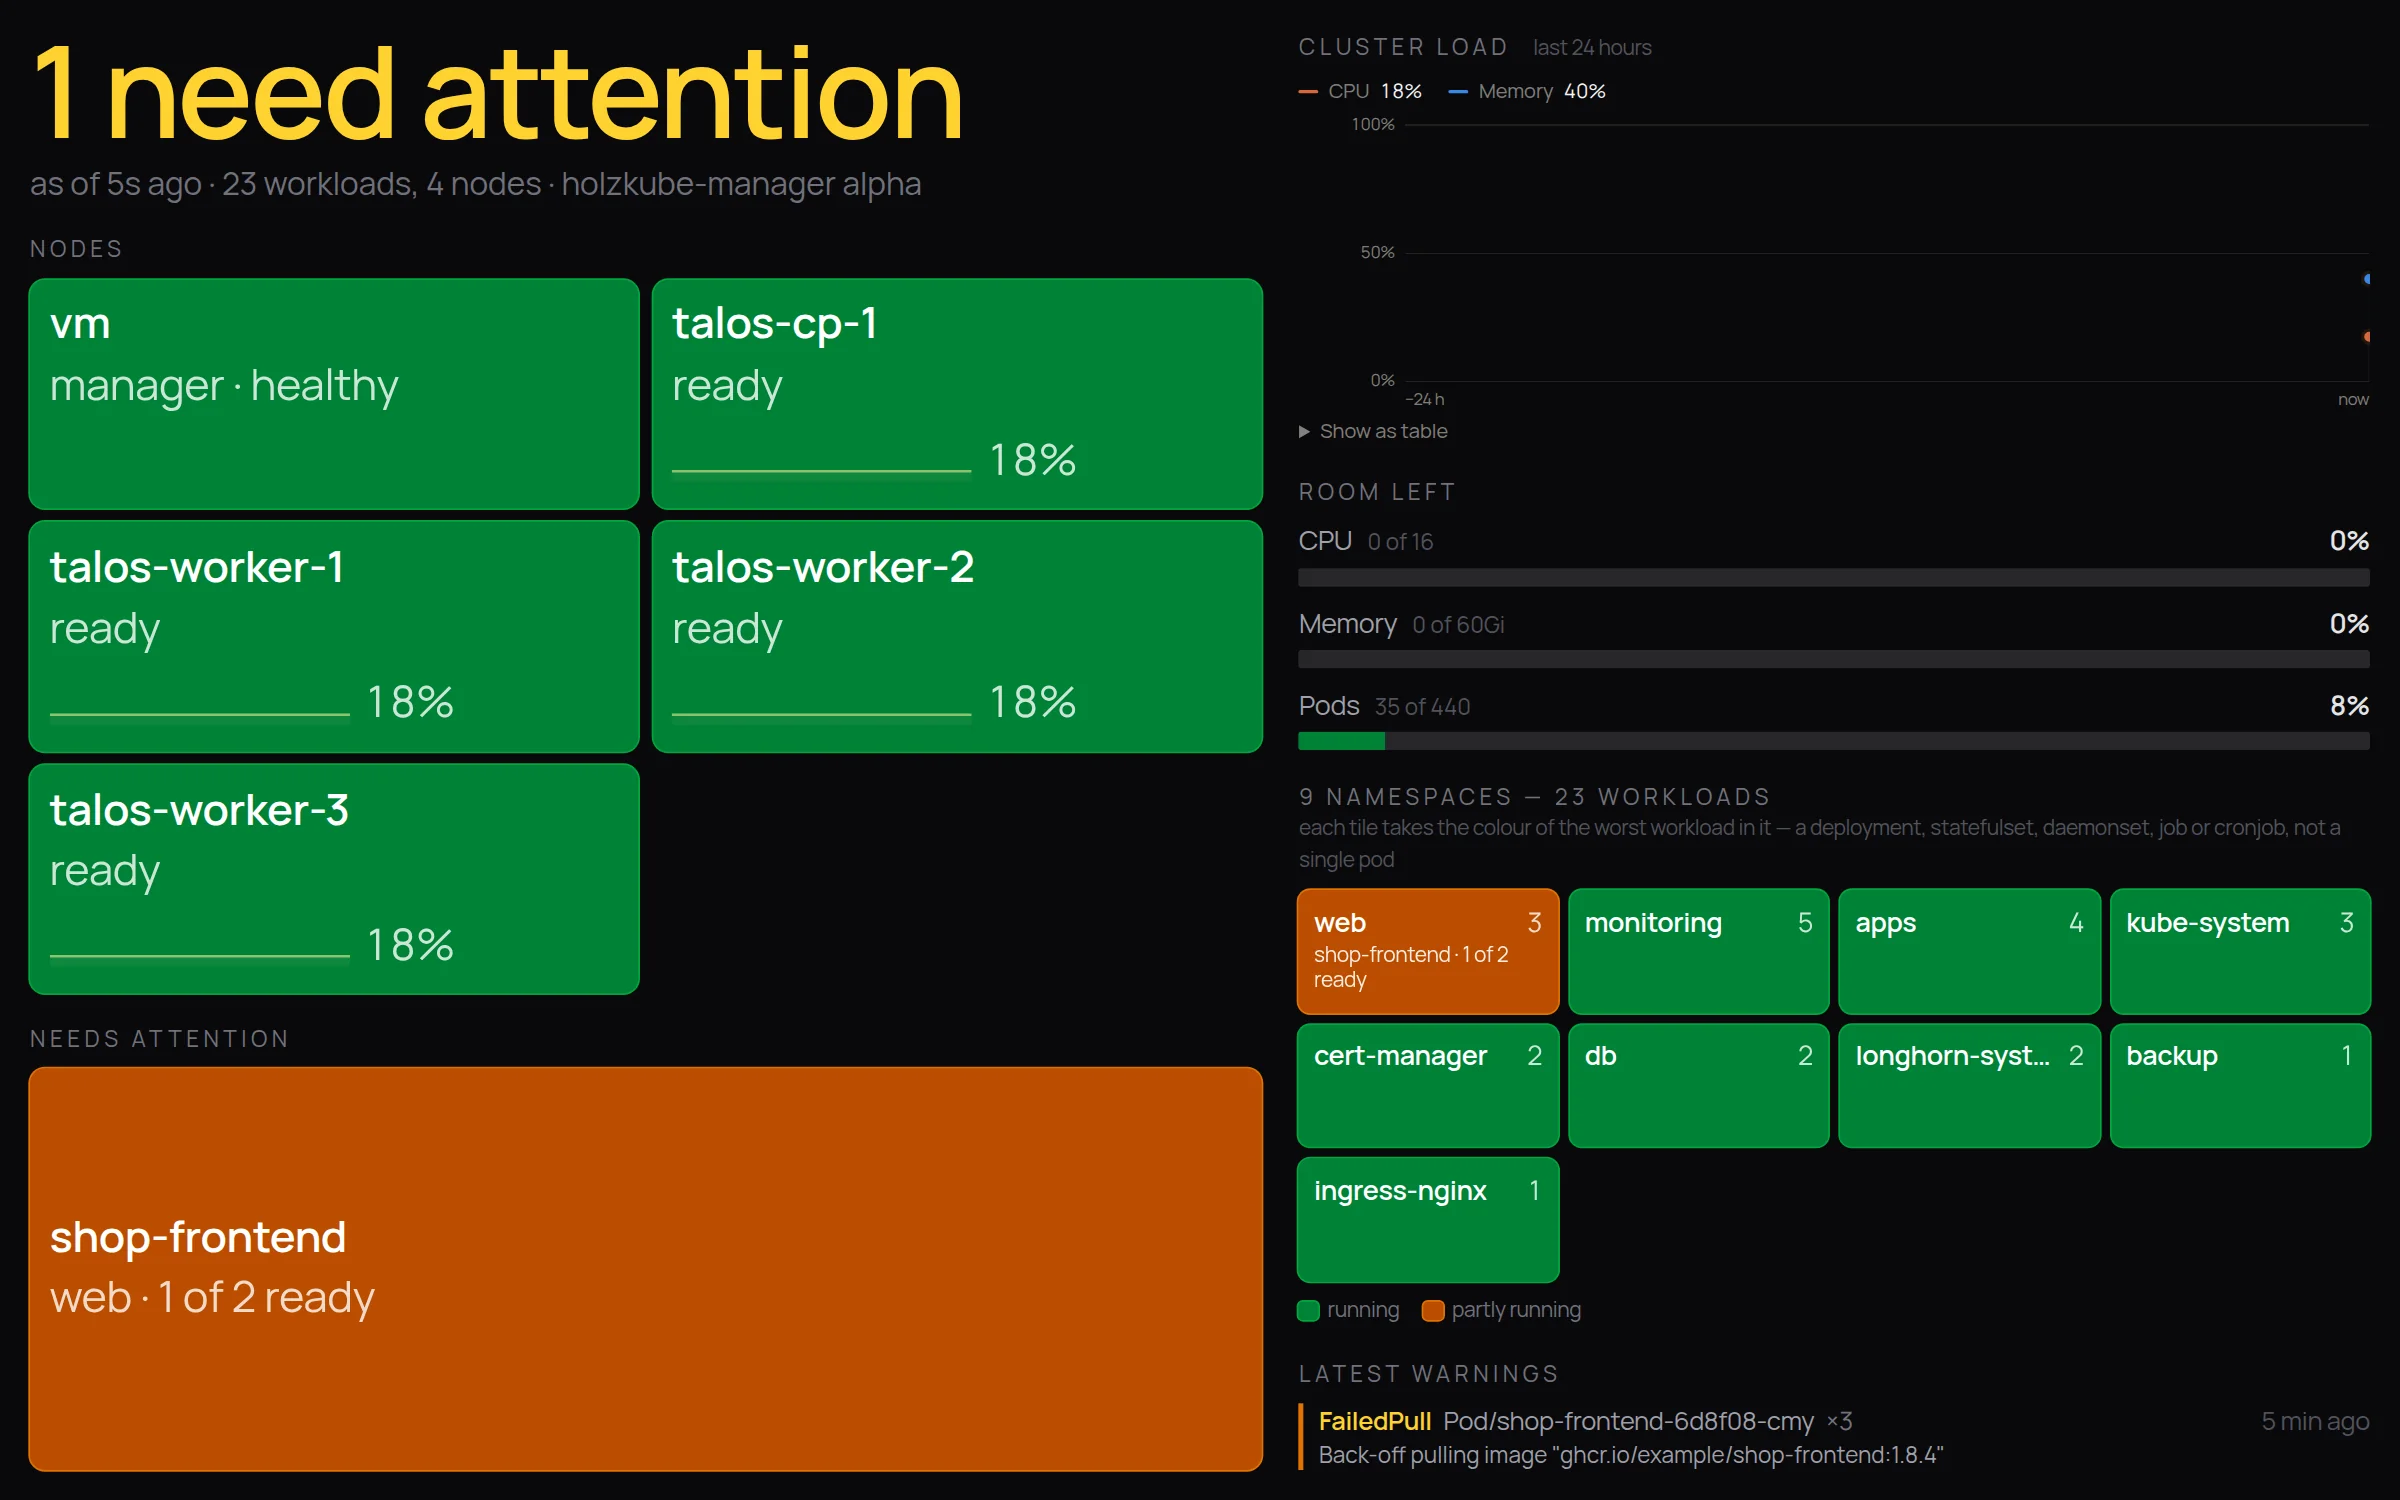
Una vista a schermo intero per il monitor in ufficio. Ogni nodo e ogni namespace è una tessera; ciò che non funziona appare grande e colorato. Un link di sola lettura, revocabile, la tiene aperta.
Inoltre: adottare cluster esistenti con talosconfig (in sola lettura finché non li si sblocca), applicare patch alla MachineConfig con diff, diagnosi di volumi orfani e binding RBAC morti, vista dell’host (il Pi) con temperature e file system, log di audit a catena di hash, ruoli e accesso OIDC, la CLI holzkubectl e /metrics per Prometheus. Lo script di aggiornamento verifica la checksum e torna indietro da solo se il controllo di salute fallisce.
Installazione
Scaricare l’archivio linux_arm64 dalla release. È l’unica architettura. Dove holzkube-manager gira già, basta sudo holzkube-manager-update. Il resto è nella guida.
Altri progetti
holzcloud-CMS, il CMS senza JavaScript, holzBar, il gestore della barra dei menu per macOS, e holzWave, il terminale scritto in Rust. Torna alla home.