Talos-Cluster verwalten, von der leeren Maschine bis zum Upgrade. Läuft neben dem Cluster, nicht darin.
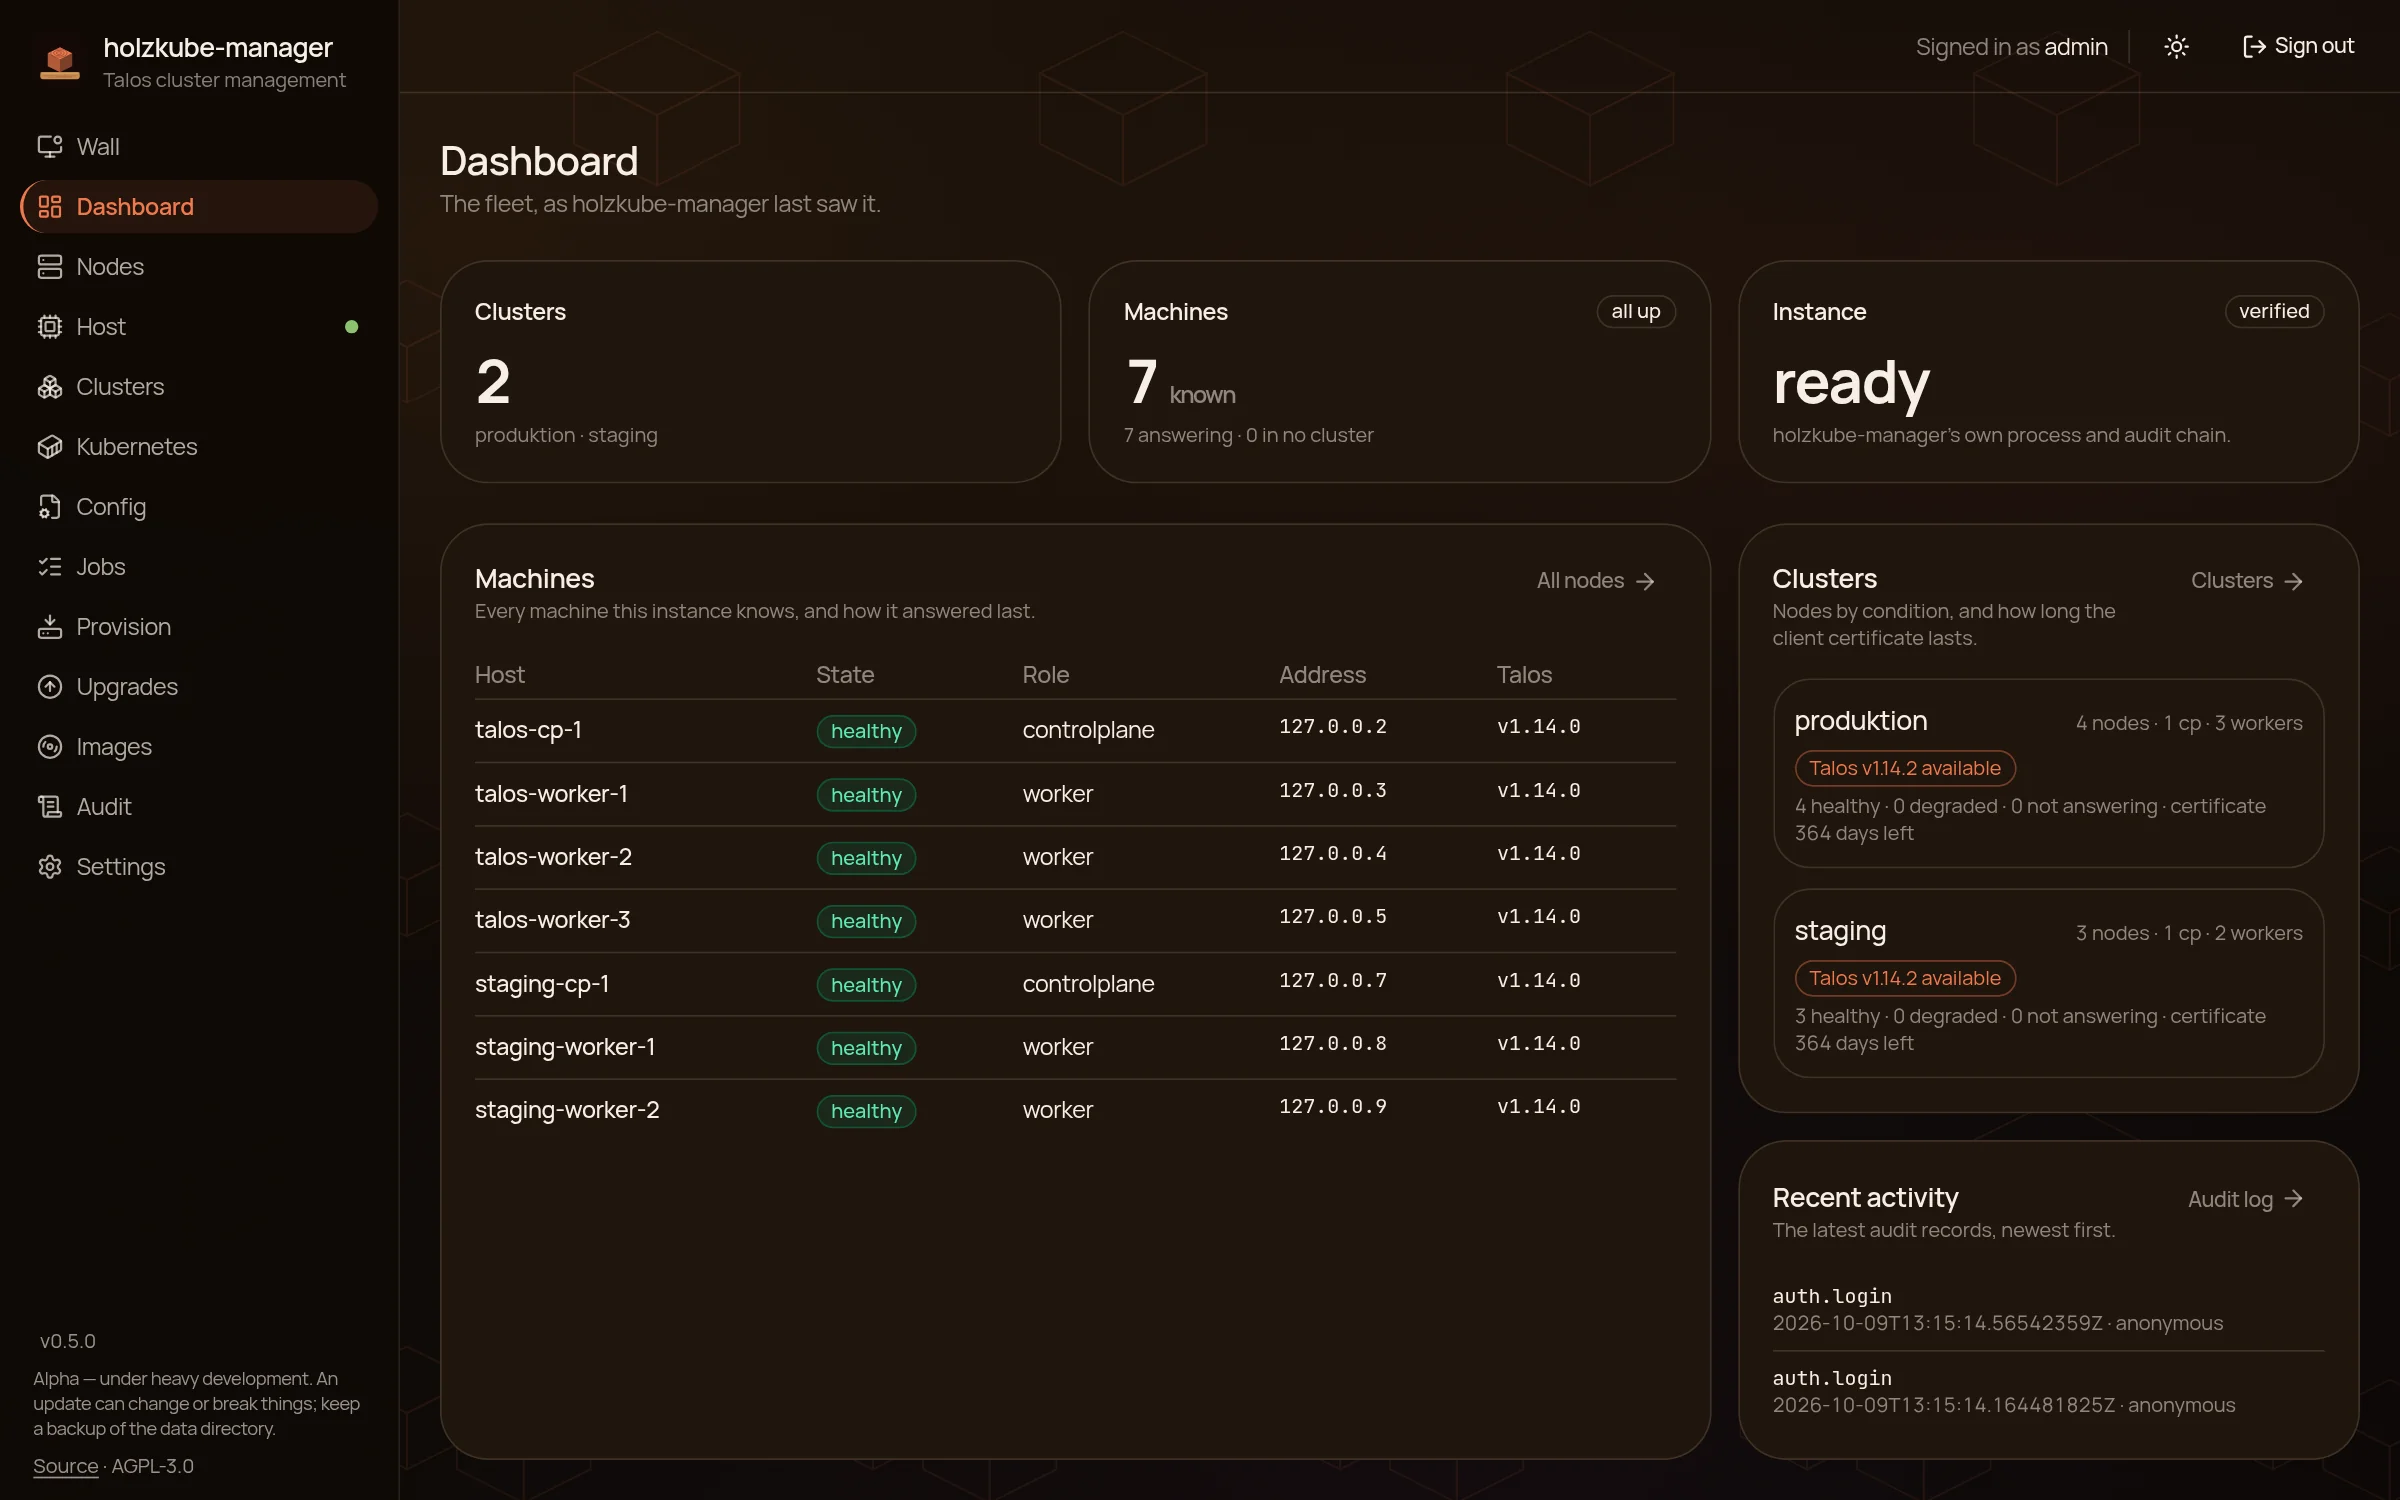
Neben dem Cluster
Bleibt erreichbar, auch wenn der Cluster down ist.
Direkt über Talos
Spricht die Maschinen-API an. Kein Agent, kein talosctl.
Blech bis Node
Maschinen finden, prüfen, konfigurieren, aufnehmen.
Sichere Upgrades
Node für Node, mit Plan, frischem etcd-Snapshot und Health-Gate.
Alpha 0.8.0: holzkube-manager ist am Anfang und ändert sich stark. Funktionen, Einstellungen und Datenformate können sich mit jedem Release ändern. Vor einem Update sichern und die Release-Notes lesen.
holzkube-manager verwaltet Kubernetes-Cluster auf Talos Linux. Ein Go-Binary läuft ausserhalb des Clusters und redet direkt mit der Talos-Maschinen-API. Es braucht keinen Agent im Cluster und keinen Cloud-Dienst. Gedacht als selbst gehostete Alternative zu Sidero Omni, unter AGPL-3.0 statt BUSL-1.1.
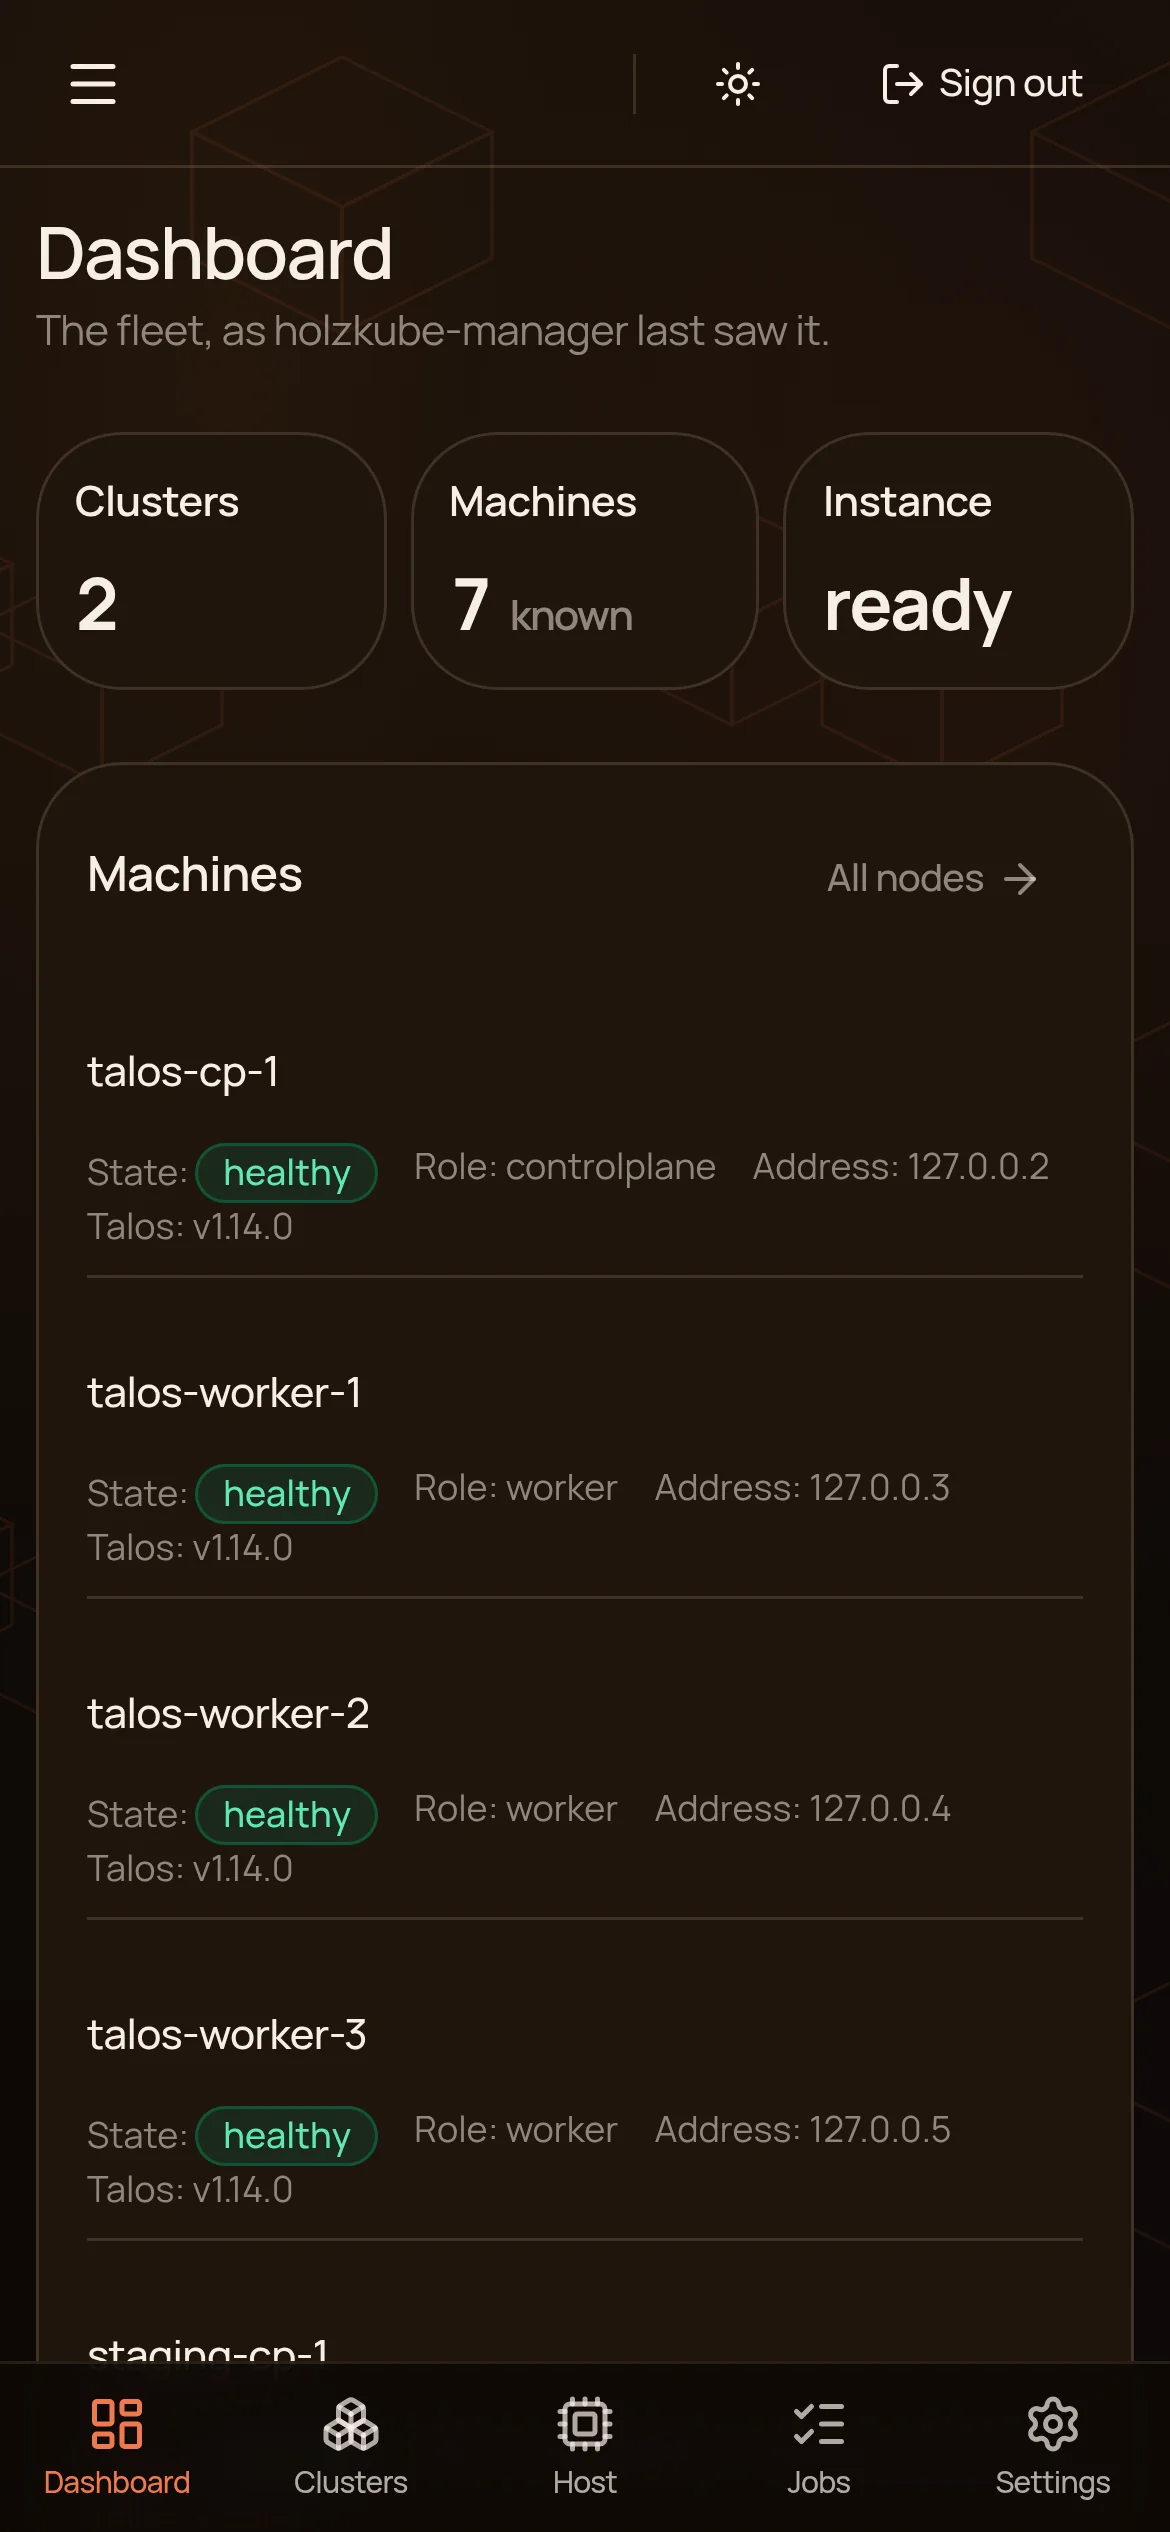
Wer einen Cluster wieder hochbringen muss, kann kein Werkzeug brauchen, das selbst im Cluster läuft. Darum ein Binary, ein Datenverzeichnis, HTTPS ab dem ersten Start, zum Beispiel auf einem Raspberry Pi 5 neben dem Cluster. Die Oberfläche funktioniert vom Grossbildschirm bis zum Handy.
Version 0.8.0 — Release auf GitHub. Läuft gegen einen echten Talos-Cluster, gebaut wird nur für linux/arm64 (Raspberry Pi 5). Die Zertifikatsüberwachung im Cluster ist bisher nur am Simulator getestet; Live-Sensoren, Wake-on-LAN und erzwungene Talos-Aktionen auf echter Hardware noch nicht. Die Konfigurationsabweichung ist noch nie gegen einen echten Talos-Cluster gelaufen: dass Talos die Konfiguration nie selbst umschreibt, dass ein Node nach einem Apply zurückgibt, was gesendet wurde, die Zeit nach einem Neustart und das Banner nach echten Stunden sind ungeprüft. Ein geänderter Secret-Wert allein bleibt unsichtbar.
Funktionen
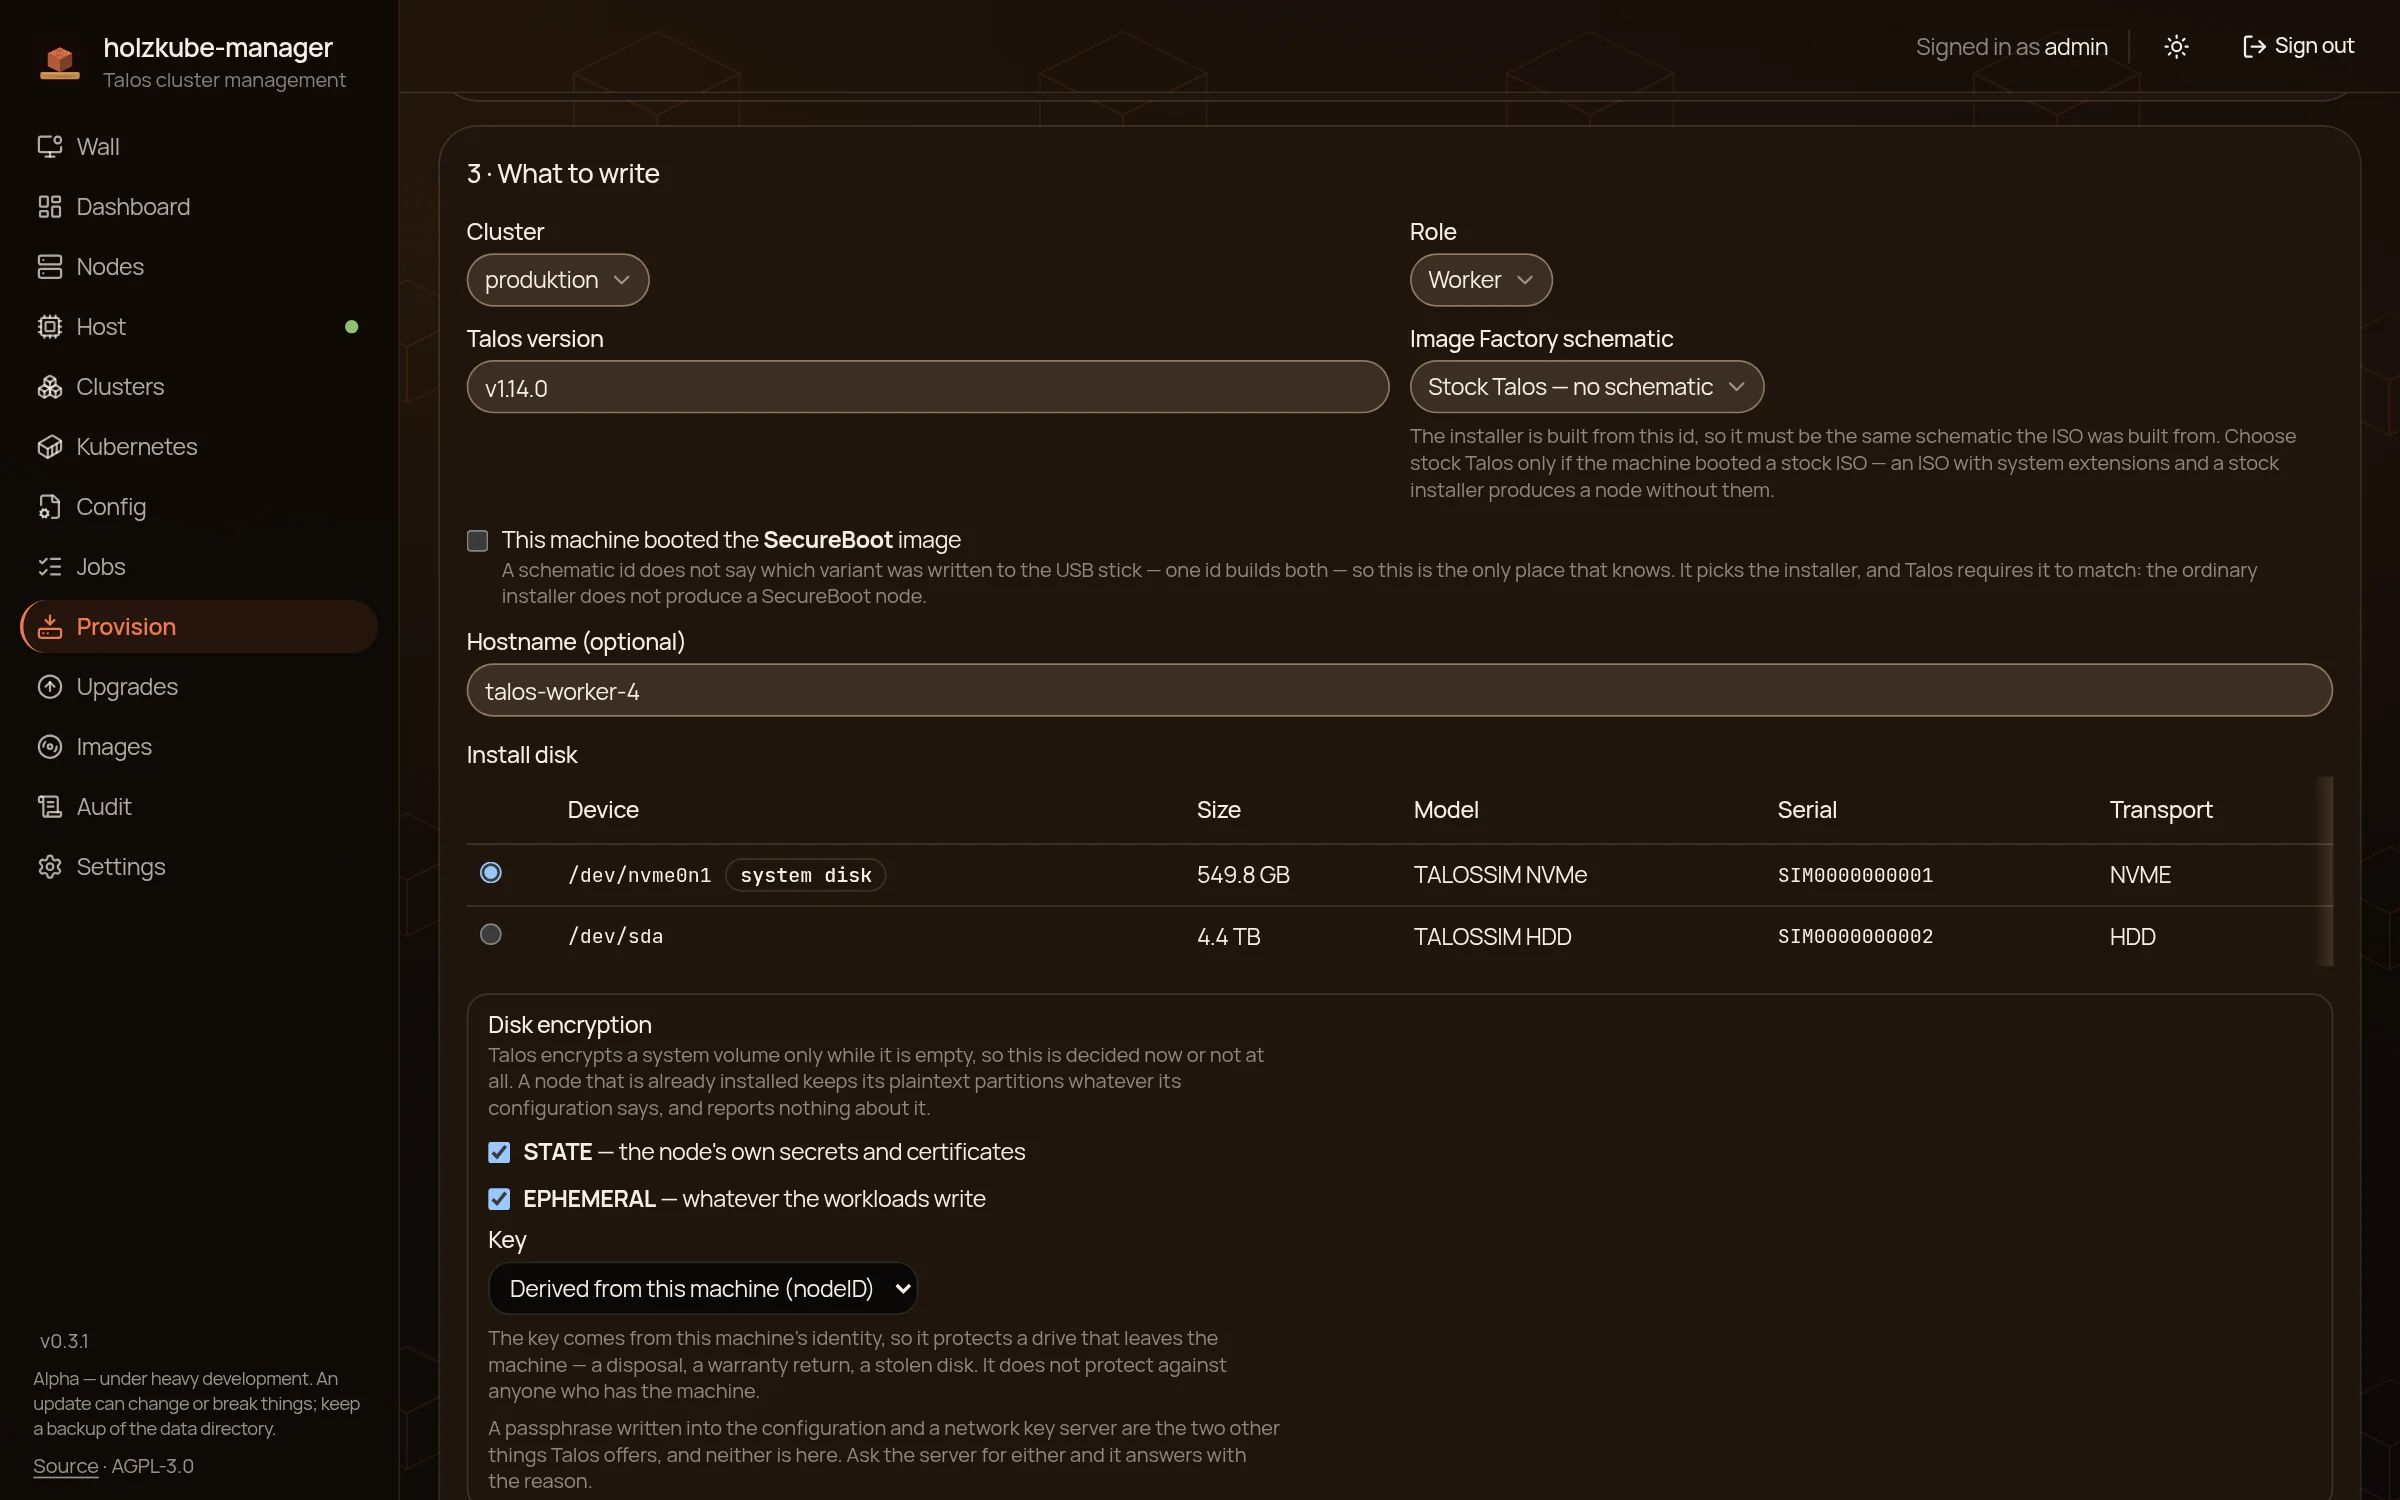
Von der leeren Maschine zum Node
Ein Assistent findet Maschinen, die vom Talos-ISO gebootet haben, prüft den Zertifikats-Fingerabdruck und schreibt die Konfiguration. Installationsdisk, Hostname und TPM-Verschlüsselung wählt man vorher.
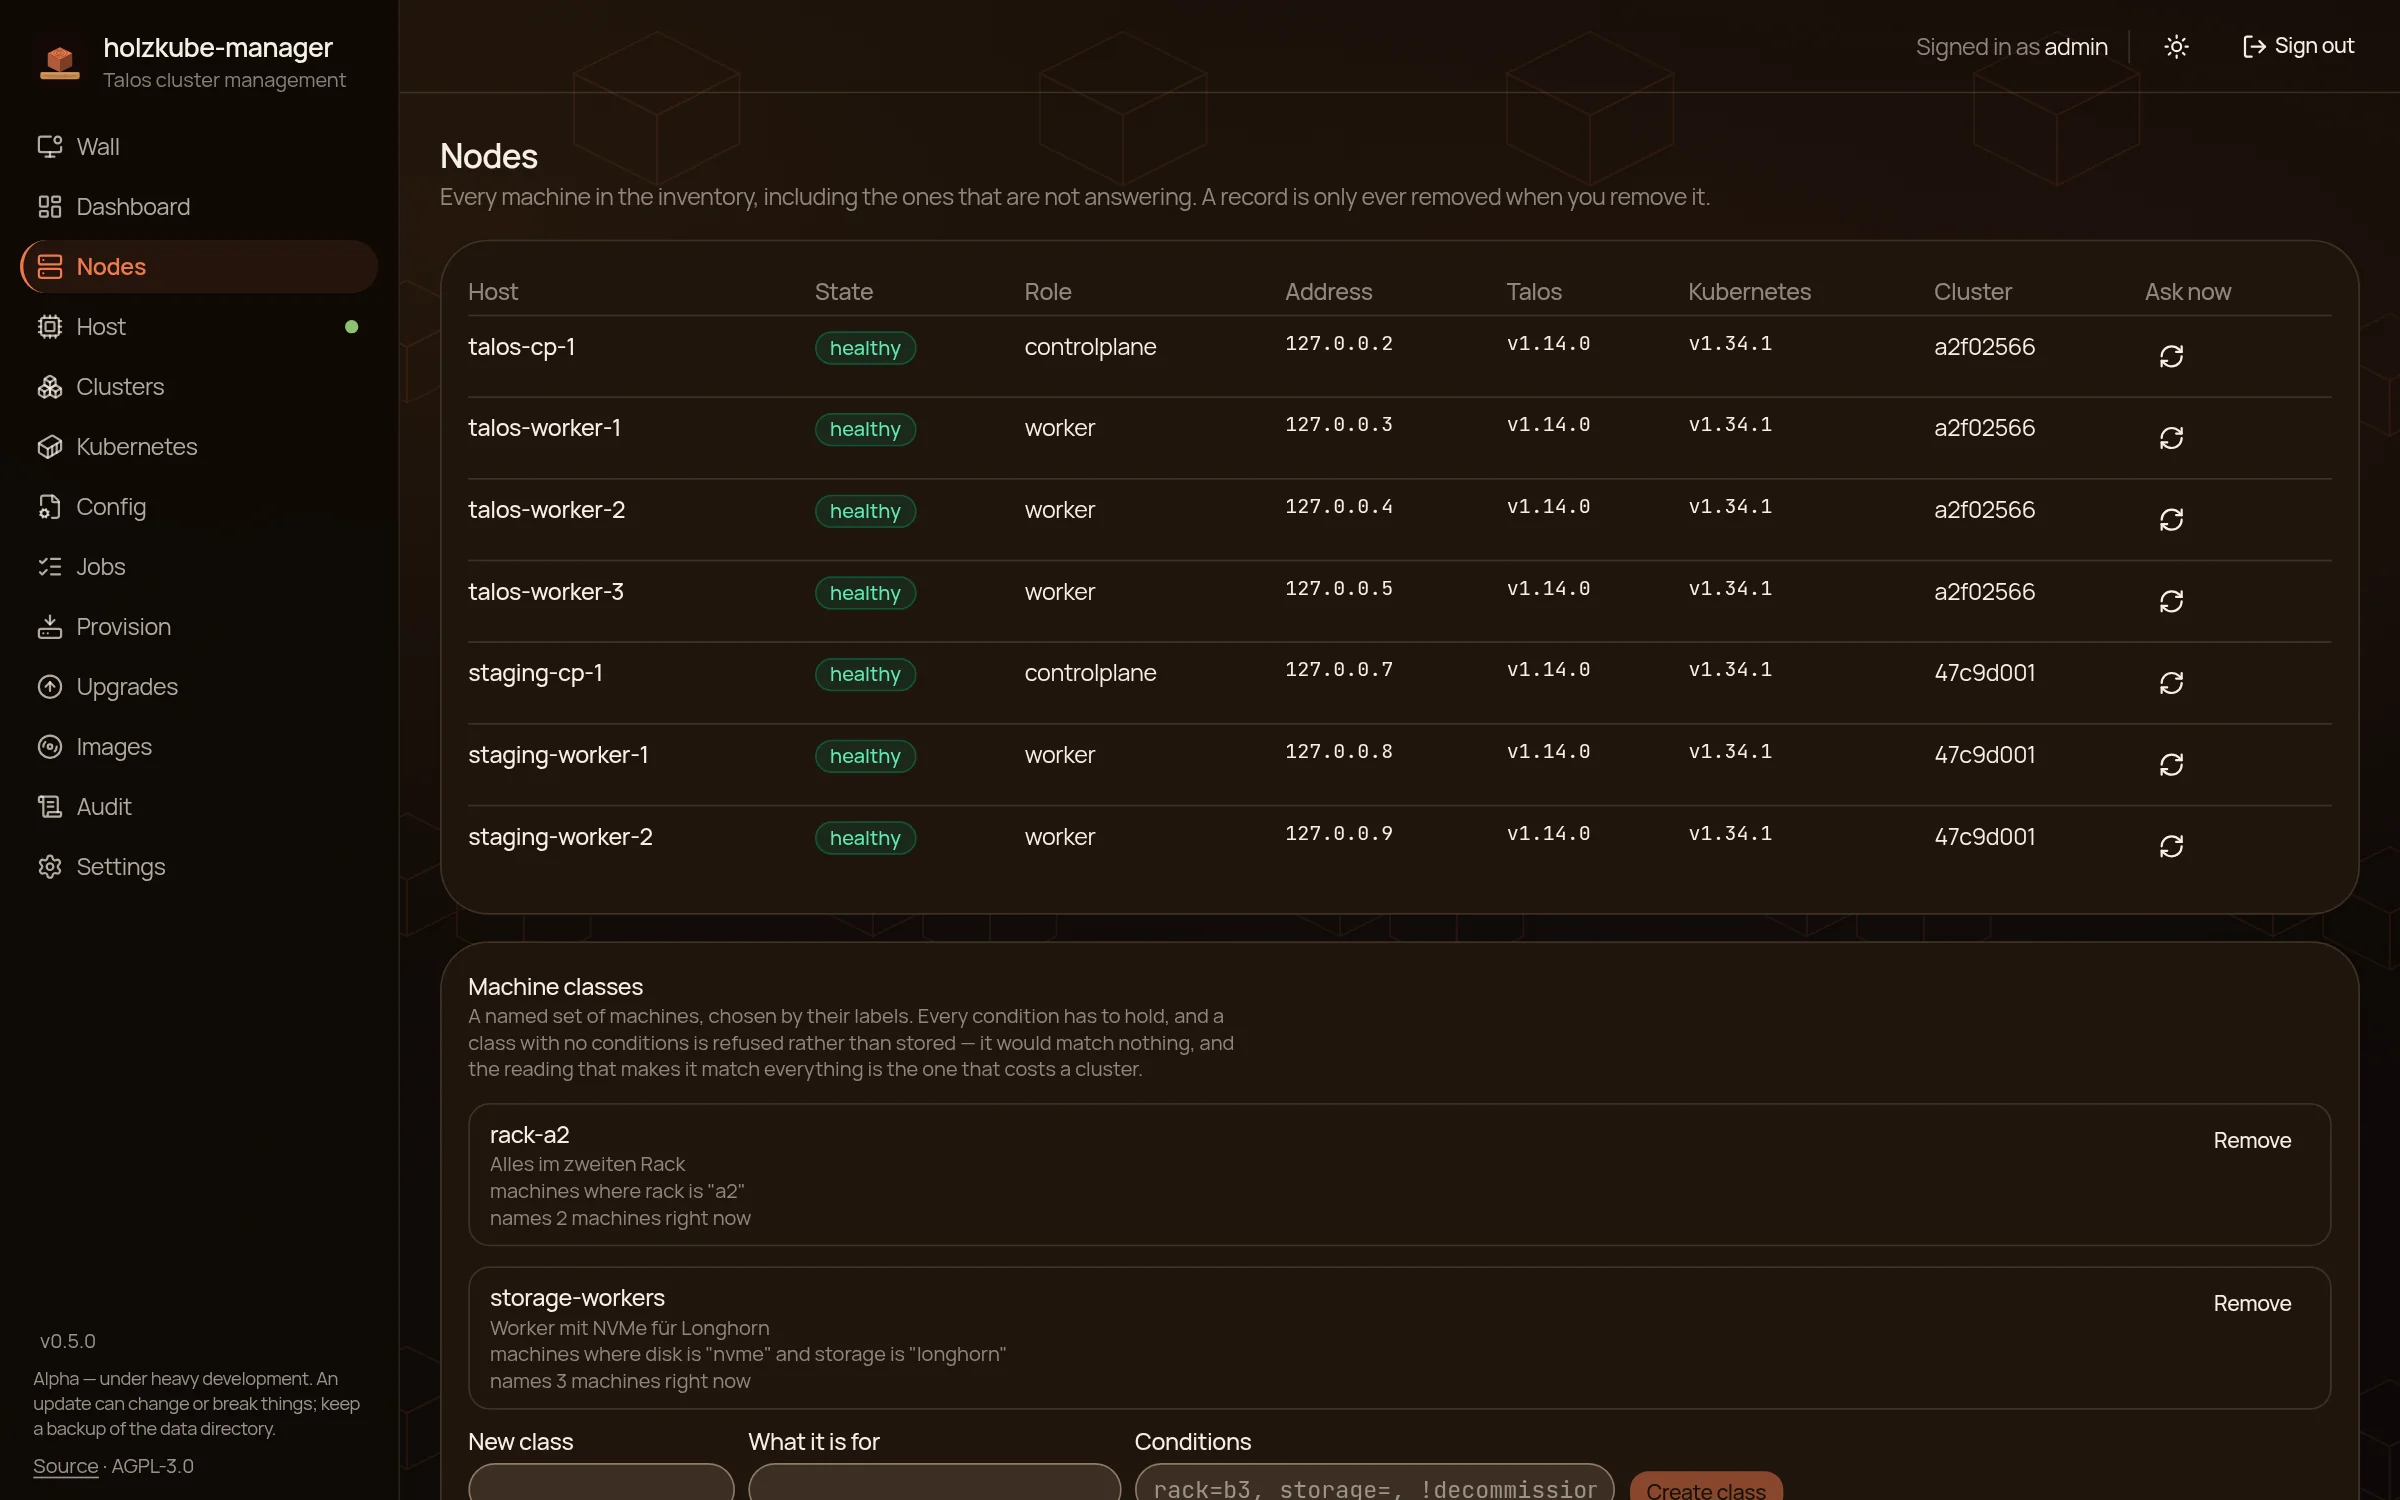
Inventar und Nodes
Jede Maschine mit Zustand, Rolle, Adresse und Versionen, auch wenn sie gerade nicht antwortet. Neustart, Reset oder Entfernen verlangen eine erneute Bestätigung. Ein Node wird als Job entfernt: raus aus etcd, Systemdisk wischen, vergessen. Der Job läuft nach einem Neustart weiter.
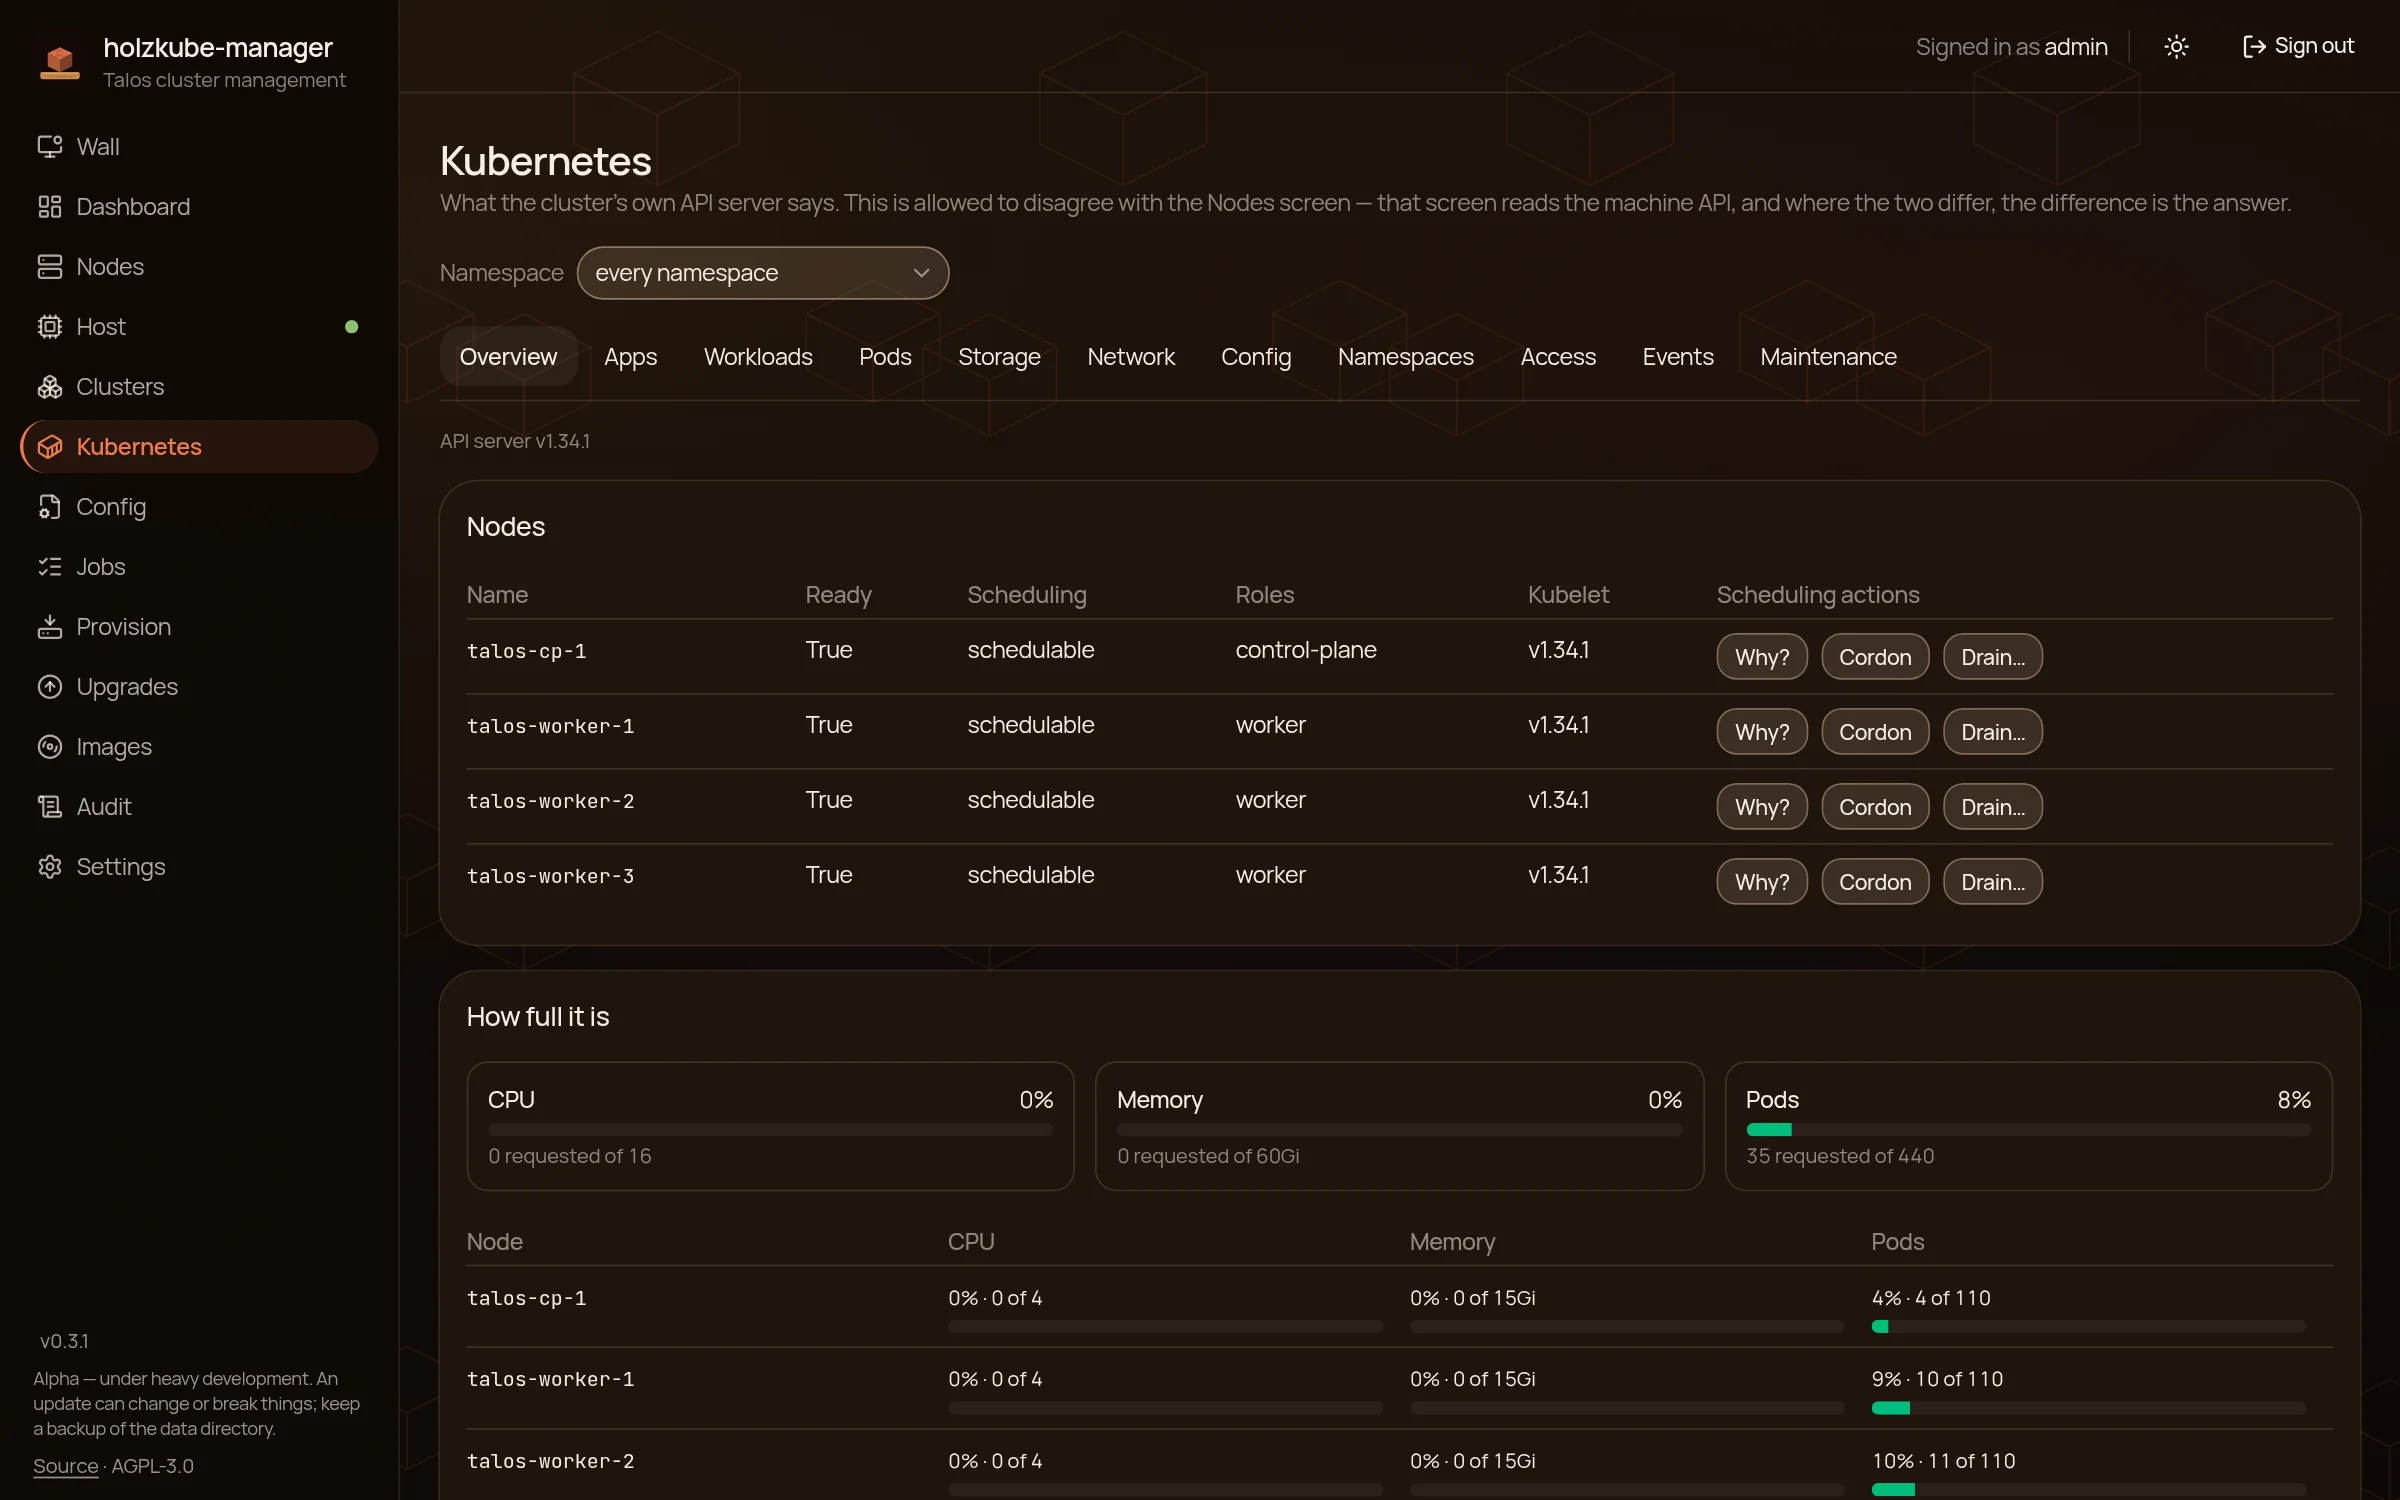
Kubernetes im Blick
Zehn Ansichten von Workloads bis Events. Nodes lassen sich cordonen und drainen, Deployments skalieren oder neu ausrollen, und bei einem kaputten Pod steht das Log des abgestürzten Laufs gleich dabei.
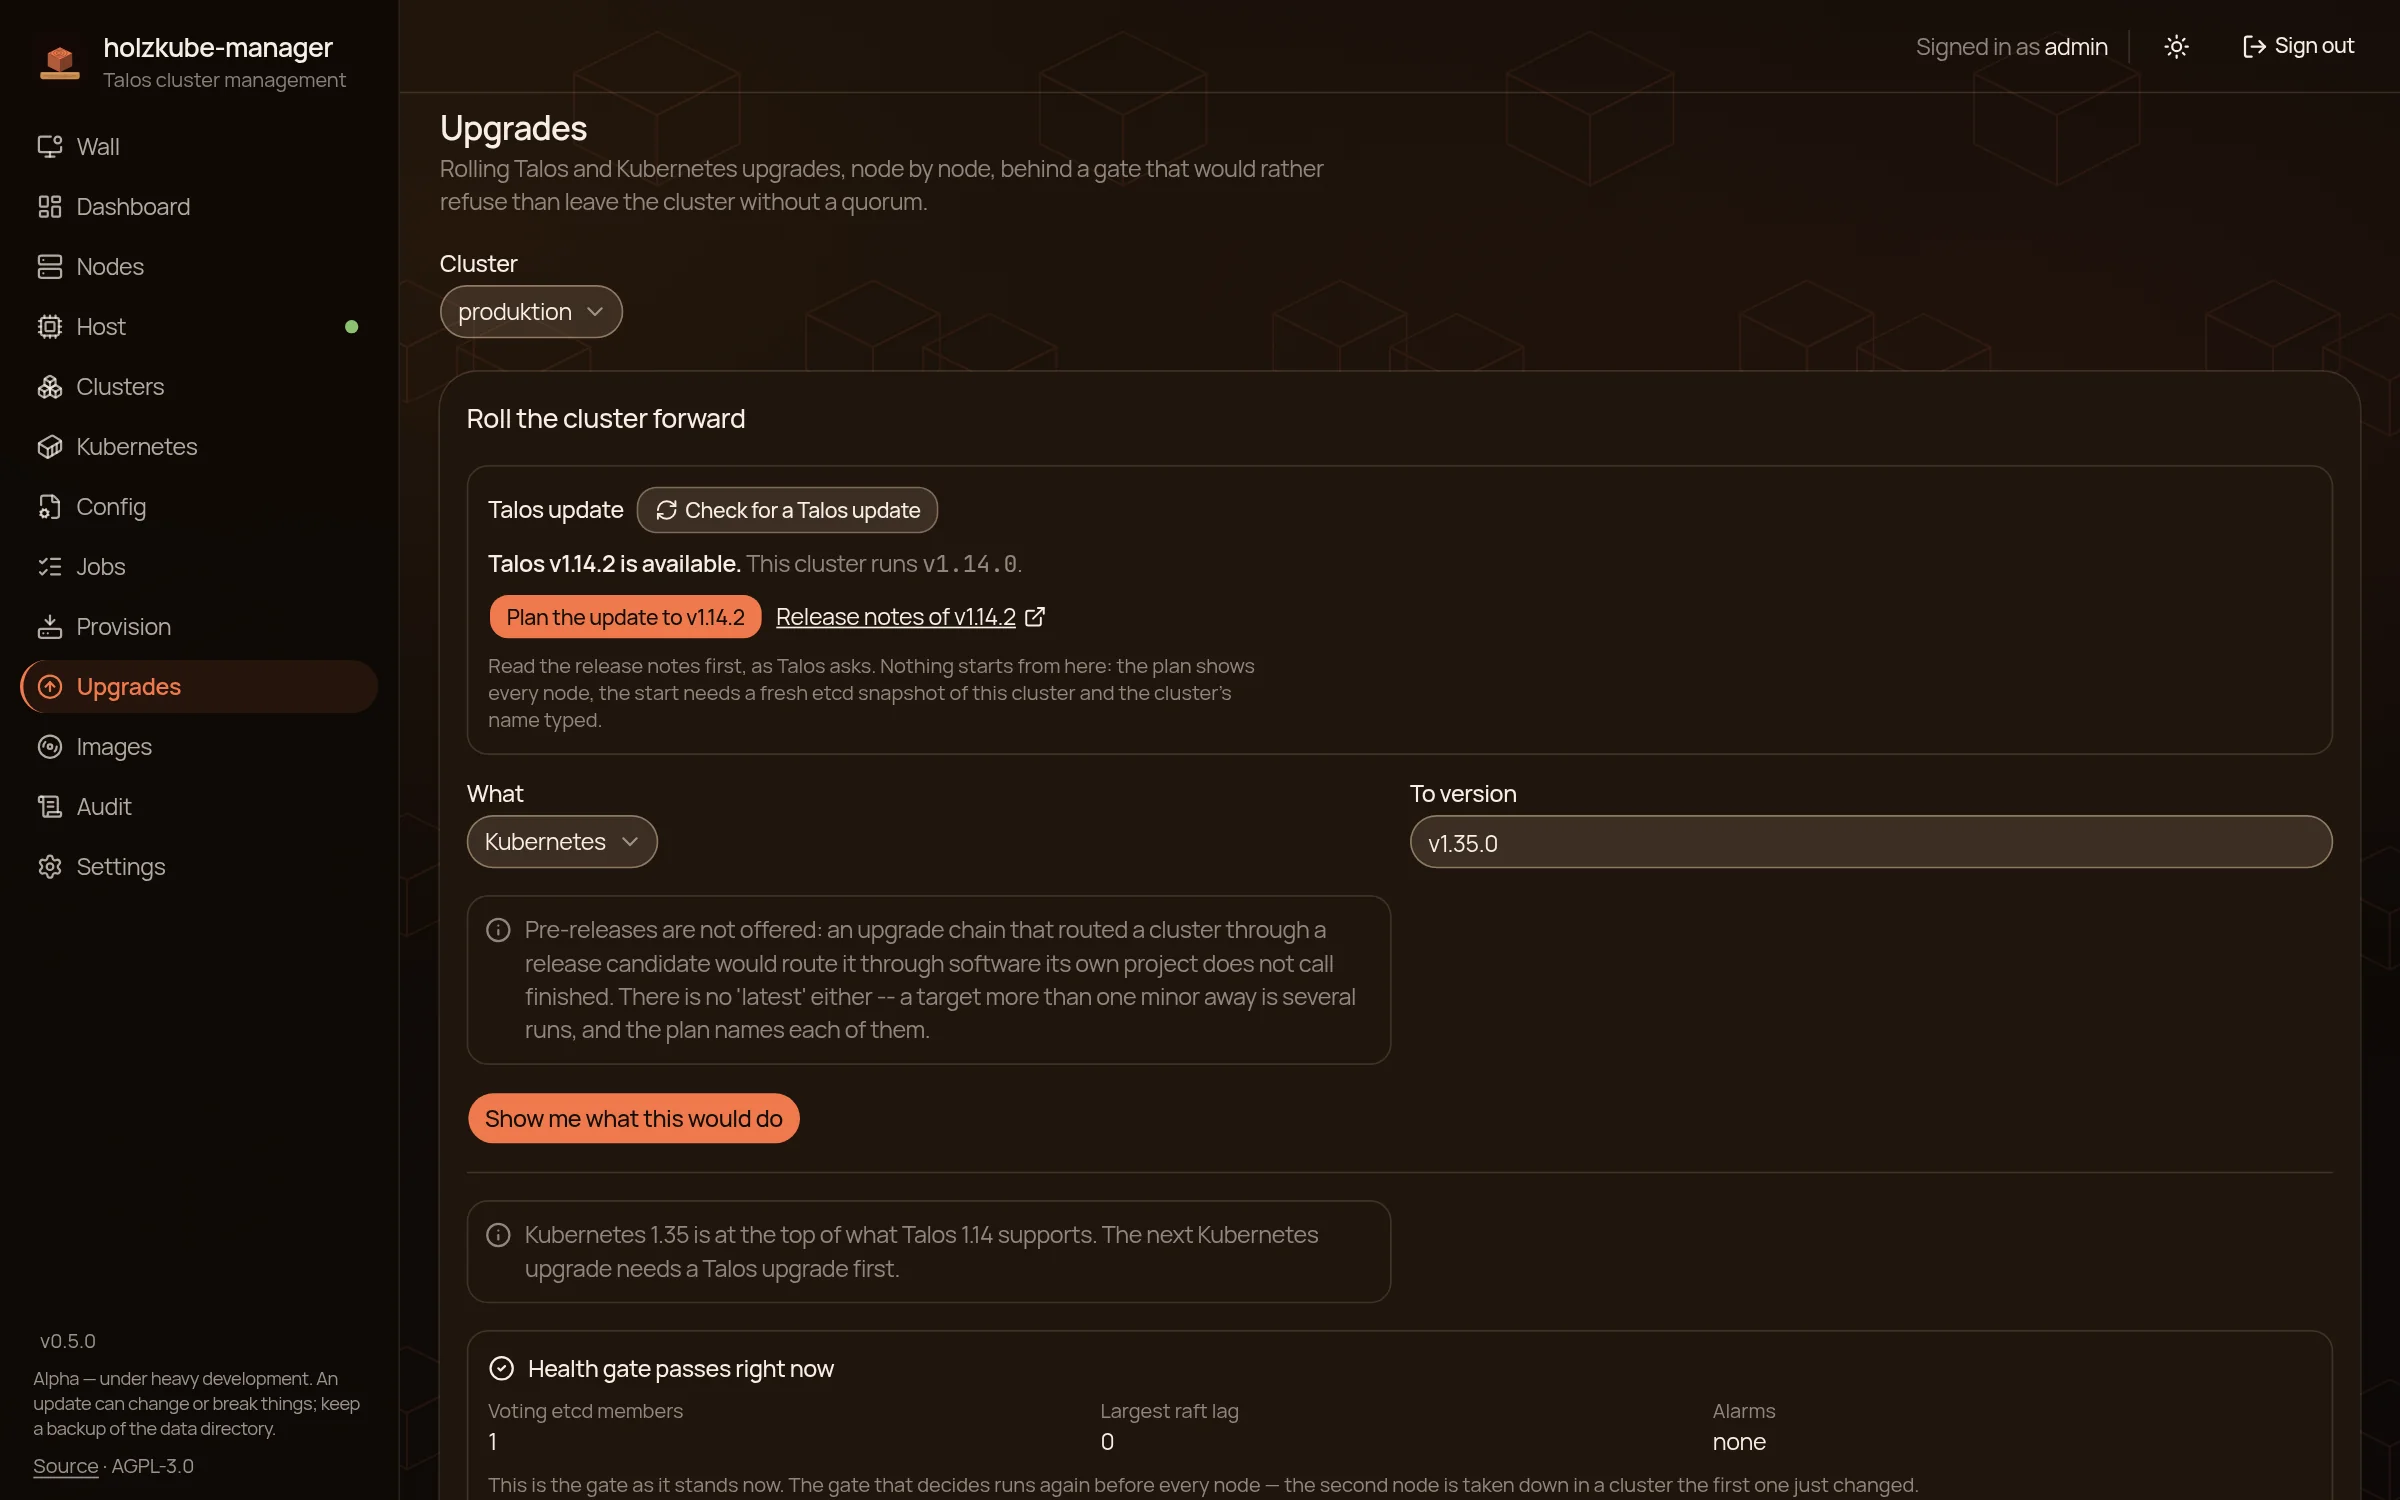
Upgrades mit Sicherheitsgurt
Talos und Kubernetes werden Node für Node aktualisiert. Zuerst zeigt ein Plan jeden Schritt. Ein Talos-Upgrade startet nur mit einem frischen etcd-Snapshot, und vor jedem Node prüft ein Health-Gate das etcd-Quorum. Bei mehreren Minor-Sprüngen nennt der Plan für jede Zwischenversion den neuesten Patch.
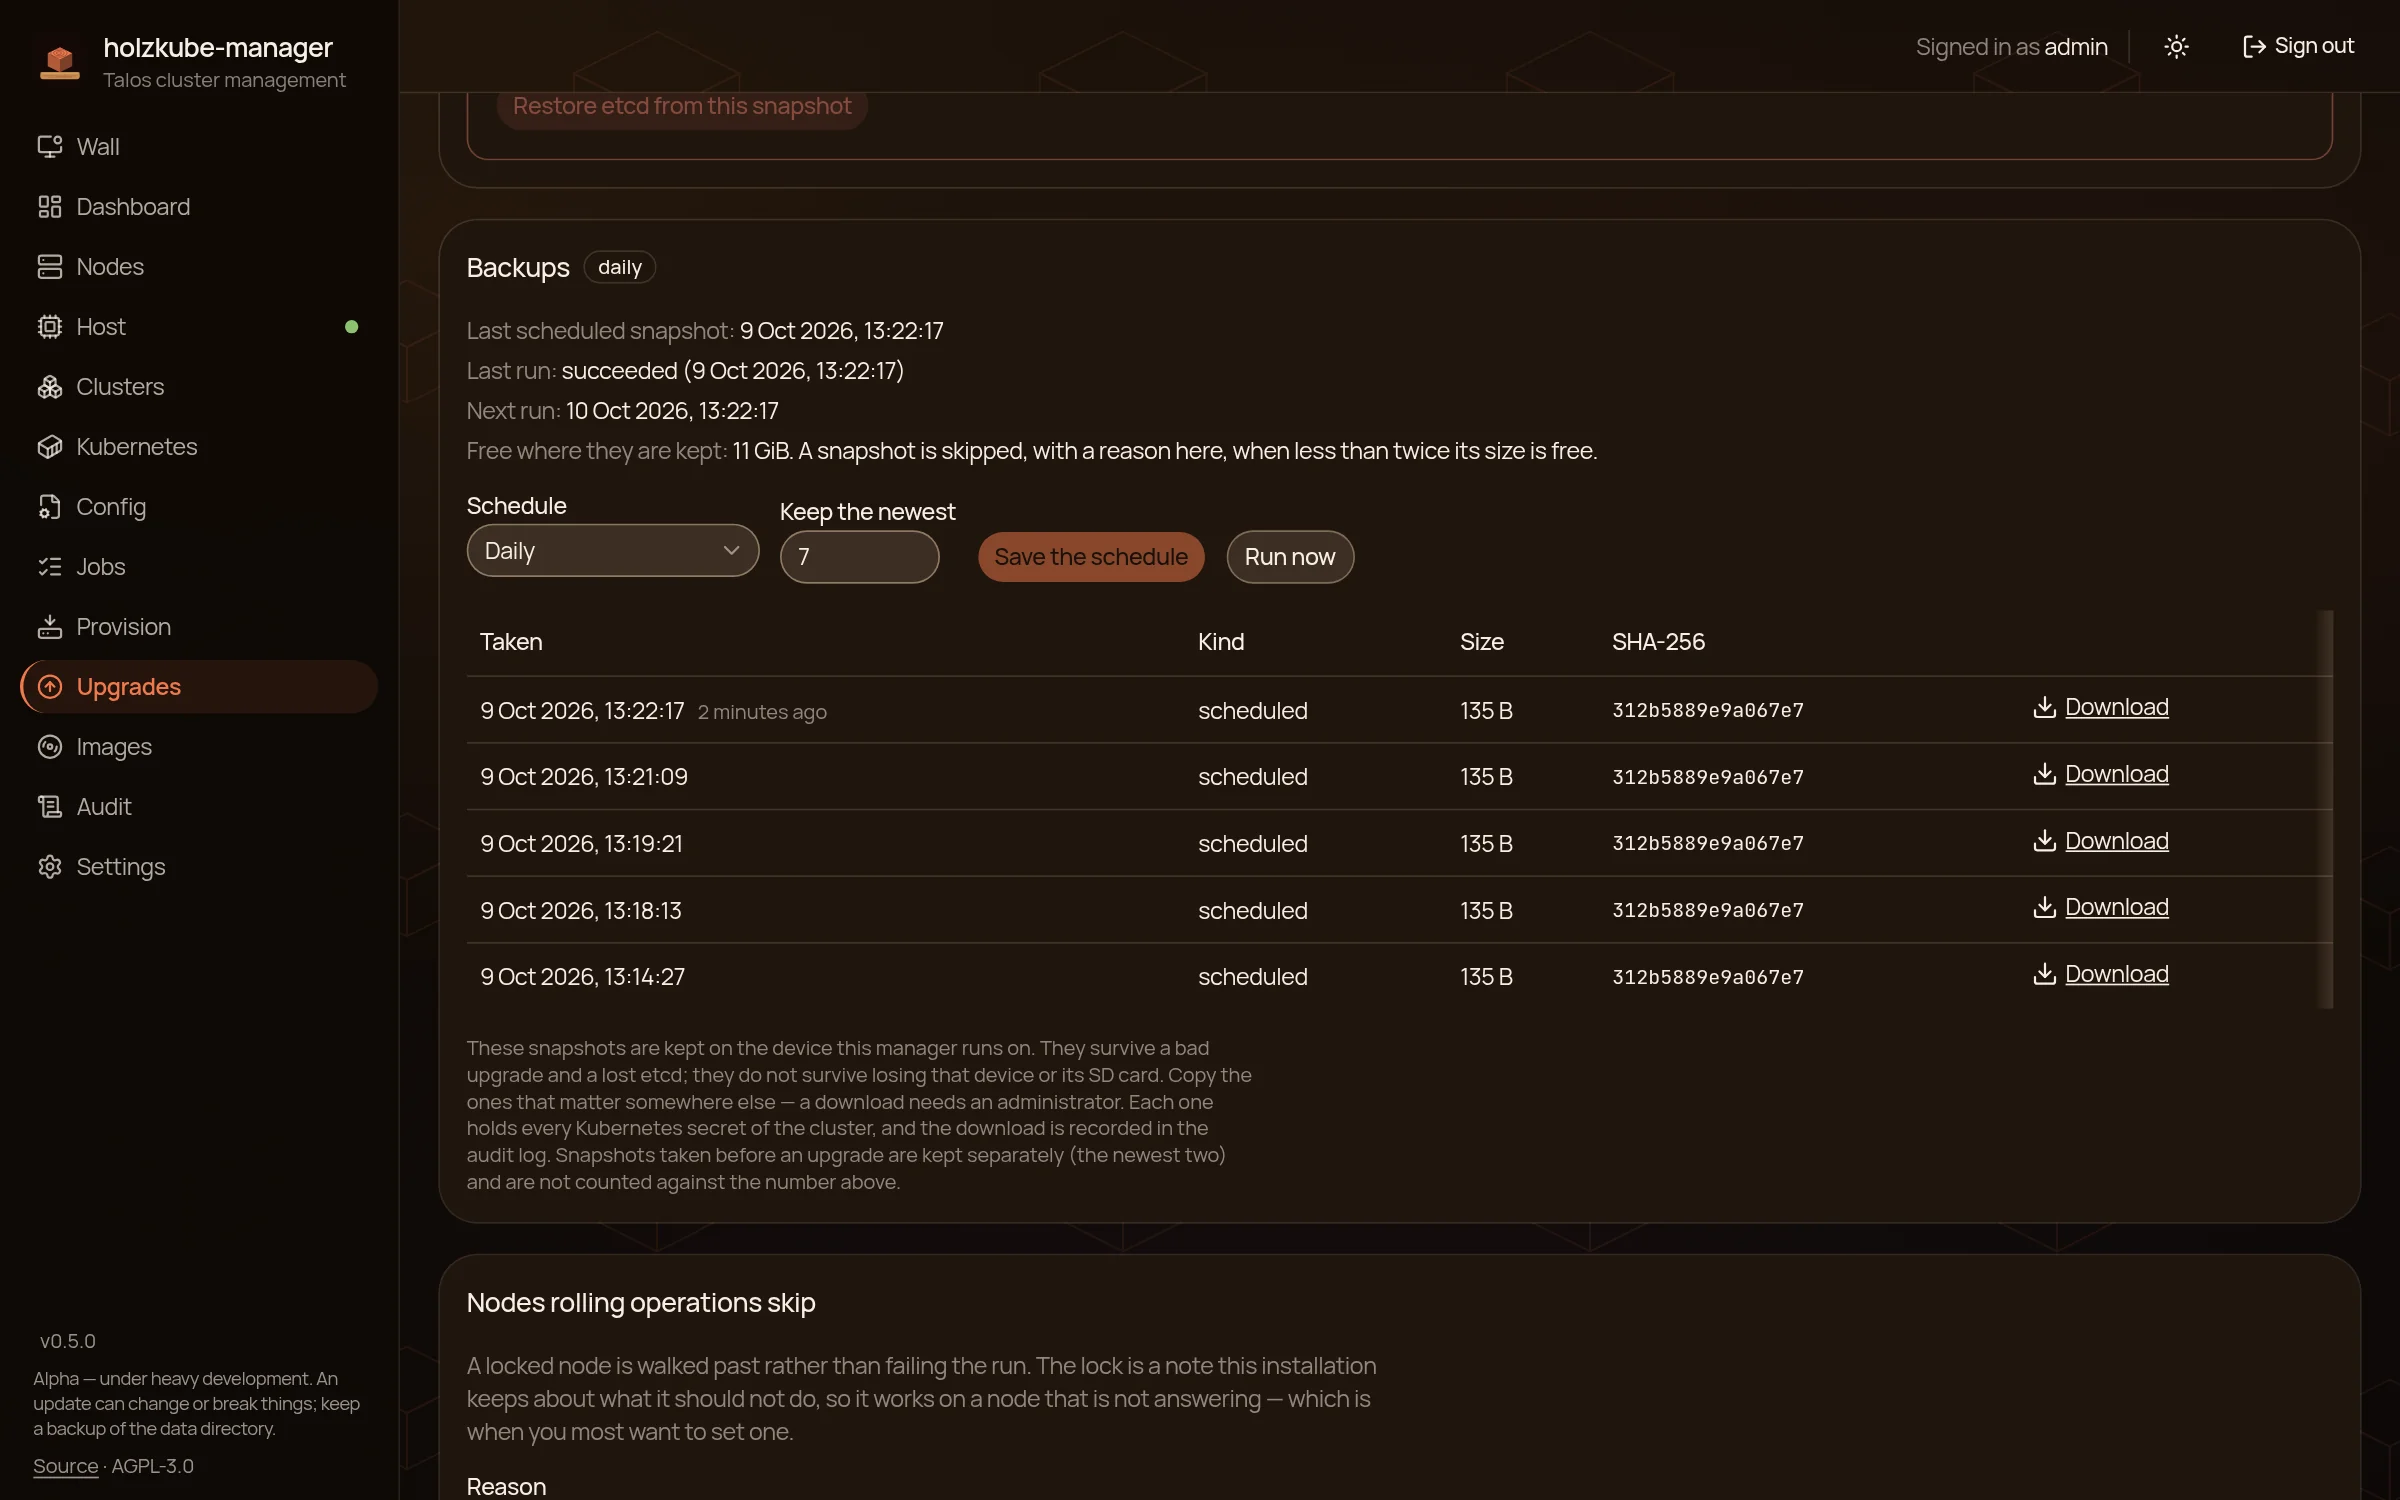
etcd-Backups nach Zeitplan
Alle 6 Stunden, täglich oder wöchentlich, mit wählbarer Anzahl aufbewahrter Snapshots. Die Liste zeigt Grösse und SHA-256. Ist das letzte Backup älter als zwei Intervalle, gilt der Cluster als überfällig. Die Backups liegen auf dem Gerät selbst und überstehen den Verlust der SD-Karte nicht, die wichtigen also anderswohin kopieren.
Zertifikate
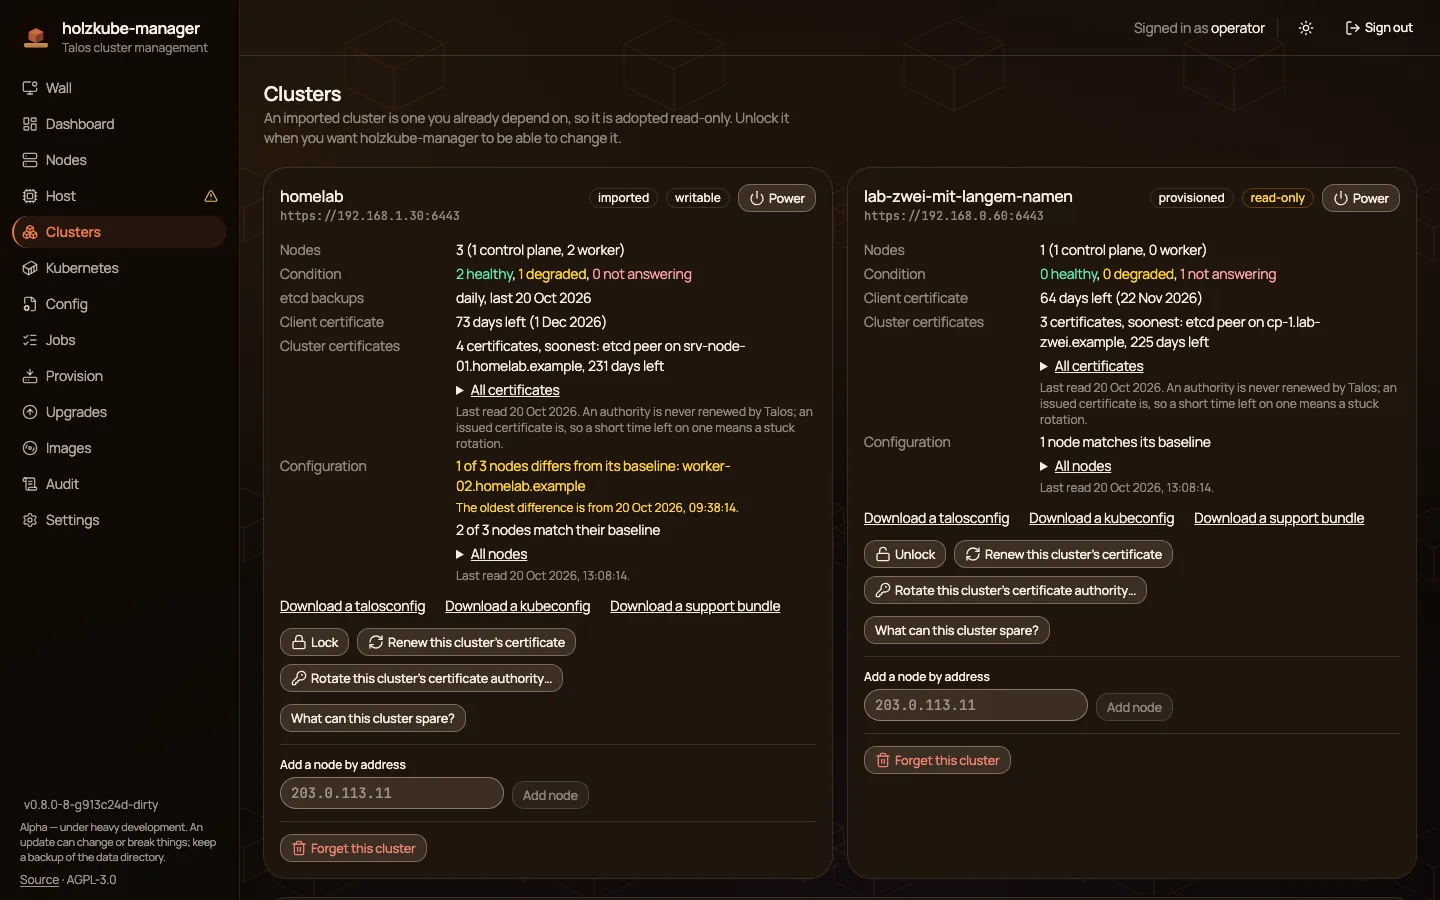
Die Clusterkarte zeigt die Restlaufzeit des Client-Zertifikats und, unter „Cluster certificates“, die der Zertifikate im Cluster (Talos-API, etcd, Kubernetes und ihre CAs), gelesen von jedem Control-Plane-Node und nach Ablauf sortiert. Wird eines knapp, erscheint ein Banner auf jeder Seite, eine Zeile auf der Wandanzeige und ein Wert in /metrics. Das Client-Zertifikat lässt sich erneuern, die Talos-CA als fortsetzbarer Job rotieren. talosconfig, kubeconfig und Support-Bundle sind herunterladbar, jeder Download kommt ins Audit-Log.
Konfigurationsabweichung
Die aktive Konfiguration jedes Nodes wird alle 3 Stunden gelesen und mit dem verglichen, was holzkube-manager zuletzt wusste oder selbst gesetzt hat. Als Baseline dient eine Kopie mit geschwärzten Secrets. Eine Änderung direkt am Node (talosctl, ein anderer Operator) erscheint mit ihrem Diff auf der Node-Seite, als Zeile «Configuration» auf der Clusterkarte und in /metrics, und als Banner, sobald sie 24 Stunden unbestätigt steht. «Confirm as intended» macht den neuen Stand zur Baseline, braucht die Admin-Rolle und die Passwortabfrage, kommt ins Audit-Log und ändert nichts am Node. Eigene Änderungen (Patch, Kubernetes-Upgrade, CA-Rotation) gelten nicht als Abweichung. Das Datenverzeichnis wechselt dafür auf Schema 7; eine zurückgerollte ältere Version lehnt es ab, der Guide nennt den Weg zurück.
Wandanzeige
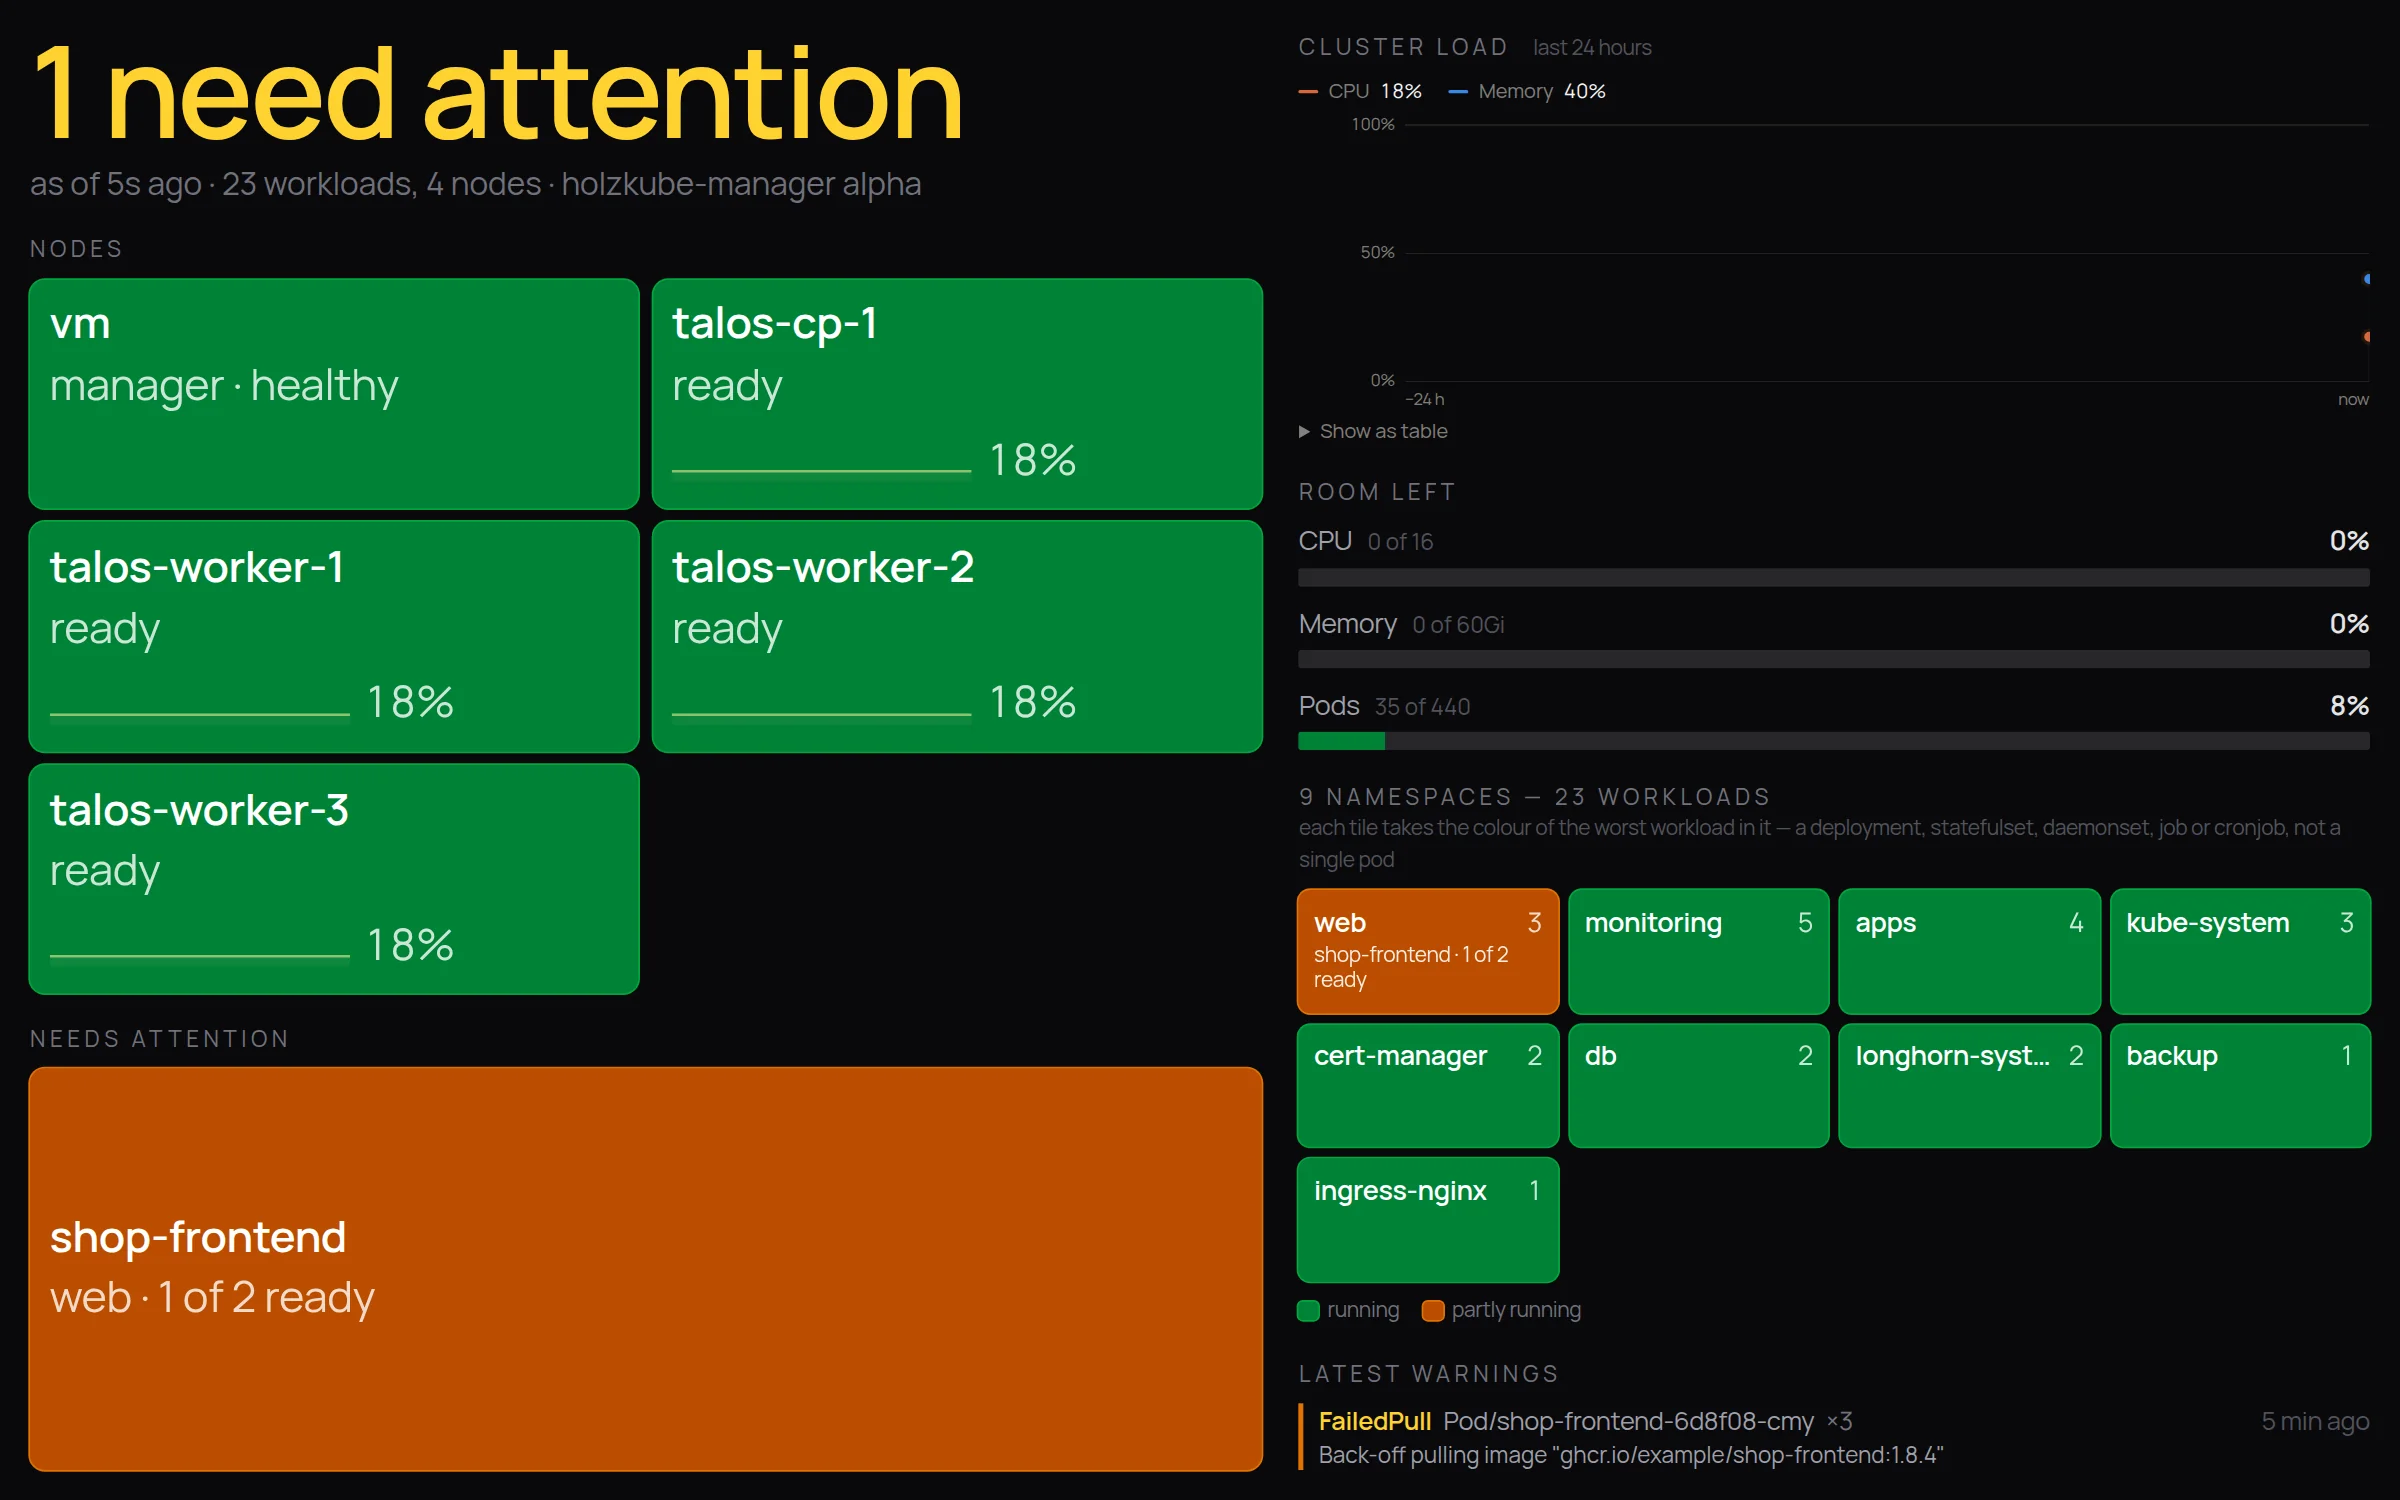
Eine Vollbildansicht für den Bildschirm im Büro. Jeder Node und jeder Namespace ist eine Kachel, was nicht läuft, erscheint gross und farbig. Ein widerrufbarer Nur-Lese-Link hält sie offen.
Ausserdem: bestehende Cluster per talosconfig übernehmen (schreibgeschützt, bis man sie freigibt), MachineConfig patchen mit Diff, Diagnose für verwaiste Volumes und tote RBAC-Bindings, Host-Ansicht des Pi mit Temperaturen und Dateisystemen, Audit-Log als Hash-Kette, Rollen und OIDC-Anmeldung, die CLI holzkubectl und /metrics für Prometheus. Das Update-Skript prüft die Prüfsumme und rollt automatisch zurück, wenn der Health-Check scheitert.
Installation
Das Archiv linux_arm64 aus dem Release laden. Es gibt nur diese Architektur. Wo holzkube-manager schon läuft, genügt sudo holzkube-manager-update. Alles Weitere steht im Guide.
Weitere Projekte
holzcloud-CMS, das CMS ohne JavaScript, holzBar, der Menüleisten-Manager für macOS, und holzWave, das Terminal in Rust. Zur Startseite.